128 ГБ VRAM для локального AI: все способы и цены
Что в ролике
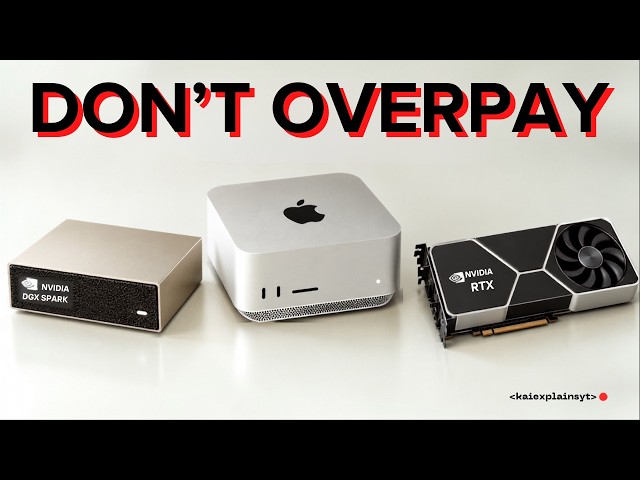
Ориентир для локального запуска большой модели — это 128 ГБ памяти, потому что 4-битная сборка модели Quinn 3.8 Flash Next весит от 94 до 124 ГБ и просто не помещается в меньшее железо. Автор объясняет, что у этой модели 125 млрд параметров и отдельная таблица на 51 млрд, из которой на каждое слово читаются лишь около 6 млрд весов, поэтому движок Strata умеет держать активную часть на GPU, а таблицу — в обычной системной памяти. На деле даже дорогие коробки не отдают под модель все заявленные гигабайты: Windows и macOS по умолчанию дают GPU около 96 ГБ, а DGX Spark за $6950 сам сбрасывает часть 124-гигабайтной 4-битной сборки на SSD. Главный практический вывод — не обязательно покупать готовую 128-гигабайтную машину: связка RTX 5070 с 12 ГБ, обычного шестиядерного Ryzen 5 и 64 ГБ оперативной памяти выдаёт от 50 до 94 токенов в секунду в зависимости от 2- или 3-битной сборки и читает промпт на 32 000 токенов со скоростью 1750 токенов в секунду. Готовые варианты с настоящим 128-гигабайтным пулом — это мини-ПК на AMD Ryzen AI Max Plus 395 (Strix Halo) от $3999, Mac Studio с M5 Max за $5999 и DGX Spark за $6950, причём Strix Halo под Linux с правильным движком выдаёт 47–54 токена в секунду на 4-битной модели, а Mac Studio около 40 на прозе и 75 на коде. Серверная сборка из четырёх подержанных Radeon Pro V620 когда-то стоила около $3000 и давала 60–70 токенов в секунду, но теперь карты подорожали и она съедает 500–600 Вт, то есть около $120 в год электричества при четырёх часах в день. Автор советует владельцам ПК с 12-гигабайтной картой сначала докупить 64 ГБ оперативки и запустить 3-битную сборку в Strata, а 4-битную машину покупать только тем, кому важна максимальная точность, и заранее понимать, что движок, а не бренд коробки решает скорость, а также что Strata пока работает только с этим семейством моделей.
Практика
- Что получишь
- Поймёте, что 128 ГБ на коробке не равно 128 ГБ под модель, и сможете выбрать между дешёвым апгрейдом ПК с 3-битной сборкой и готовой 4-битной машиной. Узнаете, какие движки использовать и где потолок такого подхода.
- Первый шаг
- Если у вас уже есть ПК с видеокартой на 12 ГБ или больше, докупите 64 ГБ оперативной памяти DDR5 и запустите 3-битную сборку Flash Next в движке Strata до покупки любой 128-гигабайтной коробки.
- Цифры
- —94–124 ГБ — размер 4-битной сборки Quinn 3.8 Flash Next, под которую и нужны 128 ГБ
- —4 токена в секунду — исходная скорость автора, против 47–54 токенов в секунду у Strix Halo с движком Strata на 4-битной модели
- —1227 токенов в секунду — чтение 160 000-токенного промпта на Strix Halo с движком GoFo, тогда как первый движок дал 113
- —$120 в год — электричество серверной сборки из четырёх Radeon Pro V620 при четырёх часах в день и 15 центах за кВт·ч
- Честно
- Автор не продаёт железо и не даёт партнёрских ссылок, только просит подписаться на будущие тесты. Почти все цифры скорости взяты из постов сообщества и README, а не из единого независимого замера, и для Mac Studio и RTX Spark сторонних тестов на этой модели ещё нет. Конкретные команды установки и конфиги в ролике не зачитываются, их придётся искать в README движков Strata и Halogen.
Если слова незнакомы — 6 терминов
- LLMбольшая языковая модель, которая умеет читать и писать текст
- 4-битная сборкамодель, сжатая так, что каждый вес занимает 4 бита вместо 16, чтобы поместиться в память
- промпттекст, который подаётся модели на вход
- токенкусочек текста, который модель обрабатывает или генерирует за один шаг
- движок инференсапрограмма, которая выполняет модель и сильно влияет на скорость
- оффлоадингперенос части весов из видеопамяти в обычную RAM или на SSD
Связки из этого ролика
5 шт.- AMD Ryzen AI Max Plus 395 + Linux + Strata
- RTX 5070 + 64GB DDR5 + Strata
- 4x Radeon Pro V620 + EPYC
- Mac Studio M5 Max + MLX Serve
- DGX Spark + CUDA
Компоненты
6 шт.Формат: разбор · для практикующих · уверенность разметки 0.93 · источник