Патч tandem.cpp ускоряет Qwen 3,8 в 3,3 раза
Что в ролике
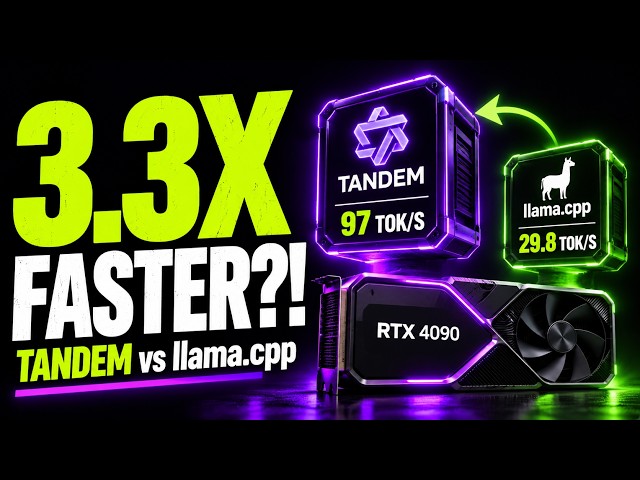
Если вы запускаете большие MoE-модели вроде Qwen 3,8 Flash Next на одной RTX 4090 с 24 ГБ, патч tandem.cpp для llama.cpp поднимает скорость с 29,8 до 97,3 токена в секунду — в 3,3 раза без смены файла модели и железа. Это не отдельный движок и не форк, а набор патчей на 8 700 строк в 35 файлах, который разработчик ewhacc опубликовал на GitHub под MIT-лицензией. Вместо того чтобы по слоям фиксировать, какие эксперты считает GPU, а какие CPU, tandem.cpp держит всех экспертов в системной памяти и оставляет в видеопамяти кэш недавно использованных экспертов, а промахи делит между CPU и копированием по PCIe по правилу движка Strata. Дополнительно включены быстрые ядра, оптимизации для gated delta net и уменьшенная с 3,6 до 1,8 ГБ черновая голова MTP. По тестам того же разработчика на GSM8K на потребительском ПК с i5-12400F, 64 ГБ DDR4 и RTX 4090 точность остаётся в пределах шума, top-токен совпадает с обычным llama.cpp в 96,1% случаев, а perplexity не меняется. Сравнение со Strata в точном режиме показывает почти паритет: 97,3 против 100,3 токена в секунду на greedy и на 48 ГБ рабочей станции tandem.cpp даже слегка обгоняет при одинаковом размере кэша. Остаются ограничения: проект заточен под одного пользователя, Linux и Nvidia CUDA, а на моделях, которые сильно больше оперативной памяти и подгружаются с SSD, он пока медленнее обычного llama.cpp.
Практика
- Что получишь
- Поймёте, где патч даёт трёхкратный прирост, на каком железе и при каких ограничениях, и сможете решить, пробовать ли его вместо Strata или обычного llama.cpp с собственным кэшем экспертов.
- Первый шаг
- Скачайте llama.cpp с коммита от 28 октября, примените патч из репозитория ewhacc/tandem.cpp и запустите встроенный скрипт сборки.
- Цифры
- —29,8 → 97,3 токена в секунду — скорость Qwen 3,8 Flash Next на RTX 4090 до и после патча
- —3,3 раза — прирост в основном тесте на i5-12400F, 64 ГБ DDR4 и RTX 4090
- —8 700 строк в 35 файлах — объём патча tandem.cpp
- —96,1% — совпадение top-токена с обычным llama.cpp при включённых оптимизациях
- Честно
- Все цифры в обзоре опубликованы разработчиком tandem.cpp, автор видео не перепроверял их самостоятельно. Для повторения нужны Linux и CUDA, Windows и AMD пока не поддерживаются, а проект рассчитан на одного пользователя. В конце автор просит подписаться и поставить лайк — это стандартная просьба, другой рекламы нет.
Если слова незнакомы — 7 терминов
- MoEмодель из набора экспертов, где на каждый токен работает лишь малая часть
- кэш экспертовобласть видеопамяти, в которой держатся недавно использованные части модели-эксперты
- gated delta netтип слоёв в Qwen 3,8, которые патч ускоряет отдельными оптимизированными ядрами
- MTPмеханизм, которым модель предсказывает сразу несколько следующих токенов для ускорения
- top-токенсамый вероятный следующий токен, по совпадению которого сравнивают качество генерации
- perplexityчисловая оценка уверенности языковой модели, ниже — лучше
- PCIeшина, по которой видеокарта обменивается данными с процессором и системной памятью
Связки из этого ролика
2 шт.- CUDA
- Linux
Компоненты
4 шт.Формат: обзор · для продвинутых · уверенность разметки 0.9 · источник