Strata ускоряет Qwen 3.8 Flash до 900 токенов/с
Что в ролике
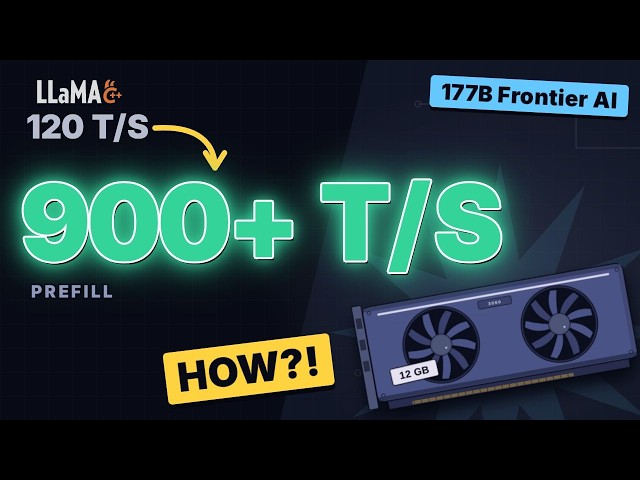
Если ваш агент ждёт модель, важнее смотреть не на скорость генерации, а на скорость префилла, и именно здесь Strata обходит llama.cpp почти в восемь раз на карте с 12 ГБ VRAM и 64 ГБ системной памяти. Автор прогнал на этой карте Qwen 3.8 Flash: Strata префиллит около 900 токенов в секунду и декодит 40, тогда как llama.cpp на той же модели даёт 120 и 26 соответственно. Движок заточен под одну архитектуру, поэтому у него нет универсальных абстракций: префилл идёт кусками по 6144 токена вместо батчей по 512, а эксперты подгружаются с pinned-памяти асинхронно в кольцо из 384 слотов на GPU. Sparse attention не строит полную маску, а читает только нужные строки KV-кэша, а MTP-голова спекулятивно черновит до трёх токенов за шаг с точной проверкой. Практически автор ставит Strata рядом с llama.cpp через прокси llama-swap: по имени модели поднимается нужный бэкенд, переключение на одну GPU занимает около 34 секунд, а возврат — 15. Ограничения честные: движок обслуживает один запрос за раз, не батчит, пиннит около 40 ГБ RAM, на Windows многоGPU-пиннинг урезан до 8 ГБ, а вывод по умолчанию не повторяется байт в байт из-за разных округлений на CPU и GPU. Для автора это уже замена 35B MOE: заказ в Instamart прошёл меньше чем за две минуты, а с 64 ГБ RAM он советует переходить на полную модель, с 32 ГБ — пробовать pruned-кодер.
Практика
- Что получишь
- Понимание, что для агентов решает префилл, а не генерация, и готовую связку Strata + llama-swap для запуска Qwen 3.8 Flash на 12 ГБ VRAM.
- Первый шаг
- На Linux с 64 ГБ RAM запустить setup.sh из репозитория Strata, дать движку скомпилироваться и указать папку с уже скачанным GGUF-квантом GSQRCO.
- Цифры
- —900 токенов в секунду — скорость префилла Qwen 3.8 Flash на Strata с 12 ГБ VRAM
- —40 токенов в секунду — скорость декода той же модели на Strata
- —120 токенов в секунду — префилл той же модели на llama.cpp до оптимизаций
- —34 000 токенов — общий объём промпта за заказ в Instamart, вывод составил 1 700 токенов
- Честно
- Прямой рекламы нет: автор делится ссылками на репозиторий, квант и свой конфиг llama-swap в описании. Движок обслуживает один запрос за раз, пиннит около 40 ГБ RAM и на Windows ограничен, поэтому повторять лучше на Linux. Часть настроек и команд видна только на экране, а проект двухнедельный — ожидай поломок между версиями.
Если слова незнакомы — 7 терминов
- префиллобработка входящего промпта и контекста до начала генерации
- декодпошаговая генерация ответа по одному токену
- KV-кэшсохранённые ключи и значения внимания, чтобы не пересчитывать прошлый контекст
- MTPмодуль предсказания нескольких следующих токенов для ускорения
- sparse attentionмеханизм внимания, который читает не все позиции, а только выбранные блоки
- pinned-памятьобласть RAM, запрещённая к выгрузке, чтобы GPU мог быстро её читать
- GGUFформат файла сжатой модели для локального запуска
Связки из этого ролика
2 шт.- Strata + Qwen 3.8 Flash
- llama.cpp + Llama Swap
Компоненты
5 шт.Формат: обзор · для продвинутых · уверенность разметки 0.85 · источник