Локальный AI на Mac тормозит не из-за чипа, а из-за кэша
Что в ролике
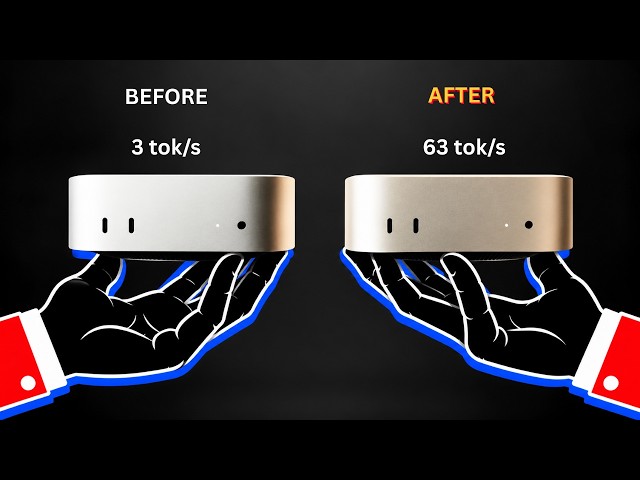
Вы покупаете дорогой MacBook Pro на M5 Max ради локального AI, а агент всё равно тратит полчаса на правку одного файла — именно такой случай описал разработчик на Reddit, потратив 8 часов на 15 правок HTML-файла. Проблема не в скорости генерации: счётчик токенов в LM Studio или Ollama показывает только фазу записи (decode), а агенты упираются в чтение всего контекста перед первым словом (prefill). На M1 Max при 8500 токенах контекста реальная скорость падала с 57 до 3 токенов в секунду, потому что чтение занимало 94% времени. Главный ускоритель — префиксный кэш: если начало запроса совпадает с прошлым, сервер пропускает уже прочитанное. На M5 Pro с Qwen 3 27B первый ответ приходил через 6,1 секунды при 400 новых токенах, а при рассинхроне кэша на 41 000 токенов — через 268 секунд, то есть в 44 раза дольше. Кэш ломают обновляемый заголовок в старых версиях Claude Code, заниженный контекст Ollama (32 000 вместо нужных 64 000 на 48 ГБ Mac), особенности архитектуры Qwen с редкими контрольными точками, неправильные фронтенды и удаление «размышлений» модели между ходами. Железо тоже важно для холодного чтения репозитория: 32 000 токенов на 27B-модели на M1 Max занимали 5–11 минут, а на M5 Max — около 40 секунд. Поэтому сначала стоит обновить Claude Code, выставить контекст Ollama от 64 000, включить debug-логи и искать в них full prompt reprocessing, проверить счётчик кэша во фронтенде и снизить effort Qwen с high до medium.
Практика
- Что получишь
- Поймёте, почему быстрый Mac может медленно отвечать в агентных задачах, и получите список бесплатных настроек для ускорения: обновление Claude Code, контекст Ollama, debug-логи и выбор фронтенда. Сможете диагностировать свой случай по логам и счётчику кэша вместо покупки нового чипа.
- Первый шаг
- Обновите Claude Code до версии не ниже 2.1.181 (или обнулите переменную окружения CODE_ATTRIBUTION_HEADER), затем проверьте в ollama ps, что контекст не занижен до 32 000 на 48 ГБ Mac.
- Цифры
- —8 часов — столько разработчик на M5 Max с 128 ГБ потратил на 15 правок одного HTML-файла
- —57 токенов/с показывал счётчик LM Studio, а реальная скорость на 8500 токенах контекста была 3 токена/с
- —6,1 секунды до первого слова при 400 новых токенах и 268 секунд при рассинхроне кэша на 41 000 токенов — та же сессия замедлилась в 44 раза
- —32 000 токенов холодного чтения 27B-модели: 5–11 минут на M1 Max против 40 секунд на M5 Max
- Честно
- Автор не продвигает свой продукт и не даёт партнёрских ссылок, но опирается на чужие отчёты с Reddit и форумов, а не на собственные замеры. Команды и значения настроек видны только на экране, поэтому для повторения чек-листа нужен сам ролик, а не только этот текст. Часть рекомендаций относится к связке Claude Code + Ollama и моделям Qwen, на других инструментах может не сработать.
Если слова незнакомы — 6 терминов
- prefillфаза чтения всего контекста перед первым сгенерированным словом
- decodeфаза генерации новых токенов, скорость которой показывает счётчик токенов
- префиксный кэшмеханизм, при котором сервер пропускает повторное чтение уже известного начала запроса
- контекствся переписка, системный промпт и файлы, которые модель читает перед ответом
- thinking tokensскрытые размышления модели, которые она генерирует перед основным ответом
- effortуровень старательности модели Qwen, влияющий на объём рассуждений
Связки из этого ролика
2 шт.- Ollama + Claude Code
- LM Studio + local model
Компоненты
7 шт.Формат: разбор · для практикующих · уверенность разметки 0.85 · источник