Nvidia PAIR: роутер локальных моделей по машинам
Что в ролике
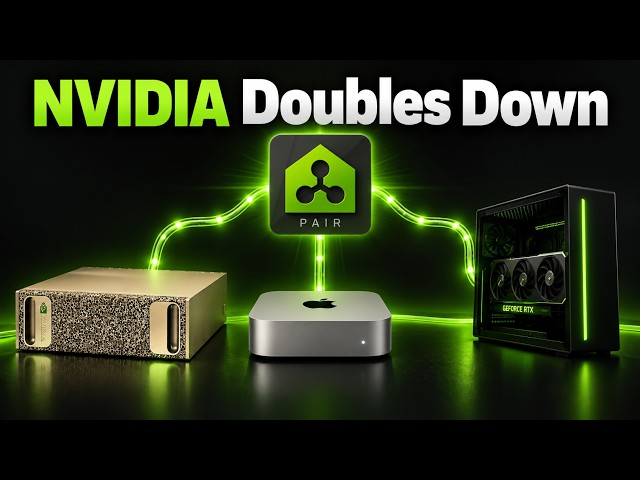
Локальный AI упирается в простое ограничение: когда агент запускает несколько суб-агентов, они встают в очередь за одной видеокартой, и Nvidia предложила роутер, который разводит их по разным машинам домашней сети. Проект называется PAIR, personal AI router, выложен на GitHub под лицензией Apache 2.0 в версии 0.1 и уже собирает pull requests на поддержку Anthropic-подобного API и llama.cpp. Принцип работы простой: роутер занимает порты Ollama и LM Studio и сам решает, на какую машину отправить запрос, поэтому агенты продолжают думать, что обращаются к локальному серверу как раньше. Это не объединение памяти видеокарт: каждый запрос по-прежнему выполняется целиком на одной машине, а больше узлов дают больше параллельных запросов, а не ускорение одного промпта. Контекст автор объясняет через цифры: Nvidia покупает Hugging Face почти за 13 миллиардов долларов, объём открытых моделей на хабе вырос более чем вчетверо с начала года, а открытые веса догоняют закрытые — Qwen 3.8 Flash Next обошла апрельский результат Claude Opus Max. Ещё один довод в пользу локального запуска — приватность: массовый пользователь, по мнению автора, не хочет снова отдавать свои данные, как это вышло с социальными сетями. Из ограничений: сейчас поддерживаются только Ollama и LM Studio, на Mac нужен чип M4 и новее, а версия 0.1 работает в пределах личной сети. Главное сомнение автора — скорость: при 300 токенах в секунду и до 380 в пакетном режиме он не уверен, что раздача вызовов по сети не съест выигрыш от параллельности.
Практика
- Что получишь
- Станет понятно, какую именно задачу решает PAIR, чем он отличается от выбора модели по API и в каких случаях несколько машин действительно ускоряют работу агентов.
- Первый шаг
- Зайти в репозиторий PAIR, поставить версию 0.1 и проверить, видит ли роутер ваш Ollama или LM Studio, прежде чем думать о нескольких узлах.
- Цифры
- —почти 13 миллиардов долларов — сумма, которую Nvidia платит за покупку Hugging Face
- —больше чем в 4 раза — во столько вырос объём открытых моделей на Hugging Face с начала года
- —55 баллов — результат Claude Opus Max в апреле 2026, который уже обошла вышедшая в августе Qwen 3.8 Flash Next
- —300 токенов в секунду, до 380 в пакетном режиме — скорость, с которой автор гоняет свою модель
- Честно
- Автор обсуждает инфраструктуру, которой пользуется сам: у него несколько ускорителей вроде DGX Spark и RTX Pro 6000, и часть выводов опирается на этот парк железа. Установка PAIR показана на старом Mac mini с M2 Pro — роутер подхватил только Ollama, LM Studio он не увидел, а поддержка заявлена с чипов M4. Раздачу моделей по машинам и связку с Radeon автор разбирает по официальному демо-видео Nvidia, а не по своему тесту, и сам называет PAIR очень ранним проектом.
Если слова незнакомы — 5 терминов
- роутерпосредник, который принимает запрос и решает, на какую машину его отправить
- суб-агентотдельный агент, которому главный агент передаёт часть работы
- открытые весамодель, файлы которой можно скачать, запустить у себя и дообучить
- pull requestпредложение изменений в чужой открытый проект на GitHub
- Ollama и LM Studioпрограммы, которые запускают модели на вашем компьютере и отдают ответы по локальному адресу
Связки из этого ролика
9 шт.- NVIDIA PAIR + Ollama — перенаправление локальных инференс-запросов между машинами домашней сети
- NVIDIA PAIR + LM Studio — проксирование портов инференс-движка через роутер
- NVIDIA PAIR + Hermes — распределение вызовов сабагентов по нескольким GPU-машинам
- NVIDIA PAIR + OpenClaw — разгрузка очереди сабагентов агента на соседние узлы
- Ollama + Apple M2 Pro Mac mini — локальный инференс на Apple Silicon
- DGX Spark + Qwen — запуск mixture-of-experts модели на локальном ускорителе
- RTX Pro 6000 + Qwen 27B — локальный инференс крупной модели на рабочей станции
- Tailscale + DGX Spark — сеть из нескольких узлов с разными моделями под сабагентов
- NVIDIA PAIR + Switchyard — возможное объединение роутинга локальных и API-моделей
Компоненты
24 шт.Формат: реакция на новость · для практикующих · уверенность разметки 0.86 · источник