Форк llama.cpp обгоняет Strata на 47% на AMD
Что в ролике
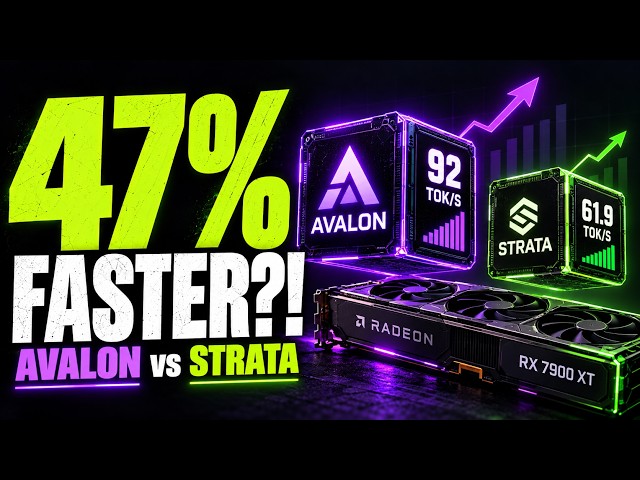
Владельцам AMD-видеокарт теперь есть смысл присмотреться к Avalon — форку llama.cpp, который на Radeon RX 7900 XT с CPU Ryzen 7 3800X и 20 ГБ VRAM выдаёт 91 токен/с на коротком промпте со спекулятивным декодированием, тогда как Strata на той же машине дала 61,9 токен/с, то есть на 47% быстрее. Avalon заточен под единственную модель Qwen 3,8 Flash Next: 48 слоёв, 512 экспертов на слой, 10 активных на токен, файл модели весит 89 ГБ, из которых 4,6 ГБ плотных весов и кэш экспертов 9–14 ГБ лежат в видеопамяти, остальное — в системной RAM. Разработчик объясняет выигрыш тем, что все каналы заняты постоянно: VRAM, CPU, PCIe и GPU работают параллельно, а кэш экспертов отдаёт свободные буферы под вычисления. Сильнее всего ускоряет спекулятивное декодирование — облегчённая черновая голова на 1,5 ГБ с урезанным словарём до 65 000 частых токенов согласуется с основной моделью в 80,7% случаев и добавляет 46% к базовой скорости. Проверка качества через перплексию на «Войне и мире», «Отверженных» и исходниках SQLite и CPython показала 1,443 у файла Avalon против 1,469 у Strata, то есть чуть лучше, но реальные ответы на задачах никто не сравнивал. Важная деталь: система с 32 ГБ ОЗУ тянет 89-гигабайтную модель за счёт memory mapping, скорость генерации почти не падает (91,2 → 89 токен/с), а вот чтение длинного промпта замедляется на 30%. Сейчас это проект одного разработчика для одной модели и карт RDNA3 под Linux с ROCm, но он показал, что отставание llama.cpp было не пределом кода, а вопросом специализации.
Практика
- Что получишь
- Понимание, чем Avalon быстрее Strata, на каких машинах его ставить и какие оговорки скрываются за цифрой 47%.
- Первый шаг
- Если у вас Radeon RX 7900 XT/XTX с Linux и 32 ГБ ОЗУ, запустить однострочный установщик Avalon и проверить скорость на коротком промпте.
- Цифры
- —91 токен/с — скорость Avalon на коротком промпте с 32 000 токенов контекста и спекулятивным декодированием
- —61,9 токен/с — скорость Strata в том же тесте, разница 47% в пользу Avalon
- —89 ГБ — размер файла модели Qwen 3,8 Flash Next
- —32 ГБ ОЗУ достаточно для запуска этой модели, скорость генерации падает с 91,2 до 89 токен/с
- Честно
- Автор ничего не продаёт и не даёт партнёрских ссылок, но и сам движок не запускал. Все цифры — замеры разработчика Avalon, независимых проверок пока нет; Strata тестировалась на версии 0.1.43 и с другим файлом квантования, поэтому сравнение не строгое. Проект работает только с одной моделью Qwen 3,8 Flash Next и картами RDNA3 на Linux с ROCm, Windows не тестировалась.
Если слова незнакомы — 8 терминов
- форккопия проекта, которую развивают отдельно с собственными изменениями
- llama.cppоткрытый движок для запуска больших языковых моделей локально на CPU и GPU
- спекулятивное декодированиеускорение генерации: маленькая модель-черновик предсказывает токены, а основная модель их проверяет
- VRAMвидеопамять на графической карте
- перплексиячисловая мера уверенности модели в тексте; чем ниже, тем лучше
- memory mappingспособ читать файл с диска по мере необходимости, не загружая его целиком в ОЗУ
- ROCmоткрытая платформа AMD для вычислений на GPU, аналог CUDA от Nvidia
- RDNA3архитектура графических процессоров AMD, на которую оптимизирован Avalon
Связки из этого ролика
2 шт.- AMD RDNA3 + ROCm + Linux
- llama.cpp + CUDA
Компоненты
6 шт.Формат: обзор · для продвинутых · уверенность разметки 0.85 · источник