Почему Strata быстрее llama.cpp на 12 ГБ: разбор бенчмарка
Что в ролике
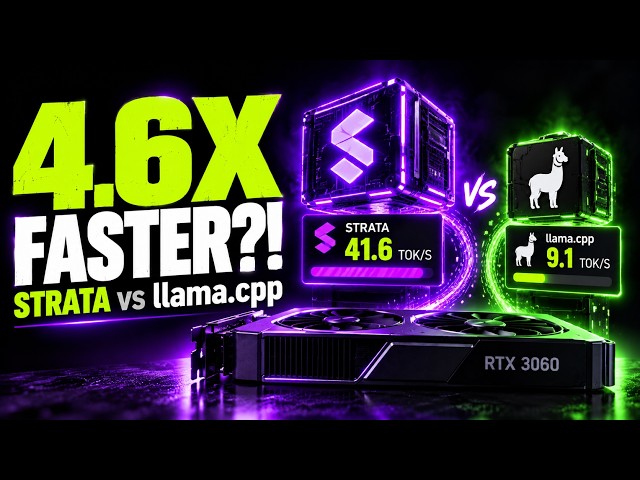
Если у вас видеокарта на 12 ГБ и вы запускаете локально Qwen 3.8 Flash Next с длинным контекстом, этот разбор показывает, почему Strata обгоняет llama.cpp. На RTX 3060 с одинаковым GGUF-файлом, промптом 4000 токенов и одинаковыми настройками llama.cpp выдал 9,1 токен/с, а Strata — 41,6, при этом первый токен приходит через 12,4 против 4,4 секунды. На промпте 32 000 токенов генерация у Strata идёт 41,8 токен/с против 8,8, а до первого токена — 30,5 против 95 секунд. Причина в том, что Qwen — смесь экспертов: в каждом слое 512 экспертов, но токен использует только 10, а Strata держит горячих экспертов в VRAM, попадая в 98,7% случаев, тогда как llama.cpp переносит целые слои экспертов в обычную память и упирается в CPU. Дополнительный прирост даёт спекулятивное декодирование: модель сама угадывает следующие токены, и 55–68% догадок принимаются. Главная оговорка: llama.cpp тестировался на сборке от 5 октября, а через два дня в нём появился собственный экспертный кэш, поэтому разрыв в 4,5 раза может быть уже меньше. Независимые тесты подтверждают превосходство Strata от 2,7 до 4,5 раза, но на моделях, полностью помещающихся в VRAM, Strata может уступать.
Практика
- Что получишь
- Понять, почему Strata быстрее на Qwen 3.8 Flash и когда выбирать его, а когда остаться на llama.cpp, с конкретными цифрами и оговорками.
- Первый шаг
- Если у вас карта 12–24 ГБ и вы работаете с Qwen 3.8 Flash, попробуйте запустить один и тот же GGUF в Strata и в свежем llama.cpp с включённым экспертным кэшем и сравните скорость у себя.
- Цифры
- —9,1 токен/с — llama.cpp на RTX 3060 с промптом 4000 токенов; 41,6 токен/с — Strata на той же карте (разрыв 4,5 раза)
- —98,7% — доля попаданий в экспертный кэш Strata на RTX 3090 при 10 500 экспертах из 24 576 на GPU
- —30,5 против 95 секунд — время до первого токена на промпте 32 000 токенов у Strata и llama.cpp
- Честно
- Цифры базового бенчмарка опубликованы самим проектом Strata, автор их не перепроверял и в ролике это прямо говорит. Часть независимых тестов есть, но мультиюзер-сравнения двух движков на этой модели до сих пор нет. Продуктов или курсов автор не продвигает, однако многие таблицы и настройки видны только на экране, так что для точного повторения замеров ролик придётся смотреть.
Если слова незнакомы — 6 терминов
- GGUFформат файла модели для локального запуска
- токен/сединица скорости генерации: сколько фрагментов текста модель выдаёт за секунду
- смесь экспертов (MoE)архитектура, где на каждый токен работают лишь несколько из сотен подсетей-экспертов
- спекулятивное декодированиечерновое предсказание нескольких следующих токенов, чтобы ускорить основной генератор
- VRAMпамять видеокарты, куда помещаются часто используемые эксперты
- экспертный кэшкэш часто используемых экспертов модели в быстрой памяти для ускорения генерации
Связки из этого ролика
2 шт.- llama.cpp + Qwen3 8B Flash Next
- Strata + Qwen3 8B Flash Next
Компоненты
3 шт.Формат: разбор · для практикующих · уверенность разметки 0.9 · источник