9-летние V100 пишут текст быстрее новых DGX Spark
Что в ролике
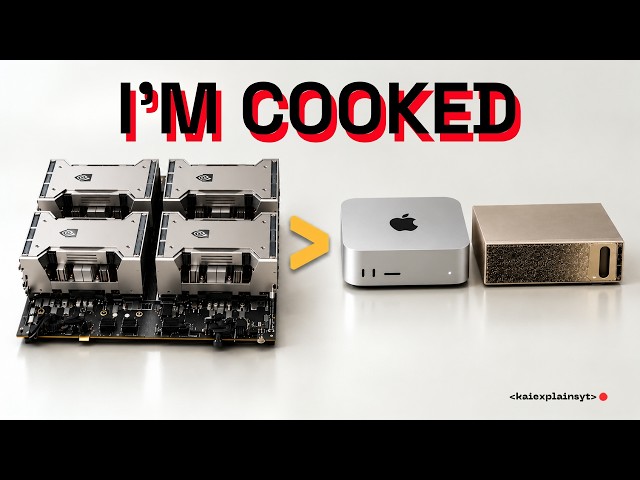
Если вы хотите запускать большую языковую модель локально, но цены на новые DGX Spark и RTX 5090 останавливают, этот разбор показывает, что четыре подержанные Tesla V100 за $3500 могут писать текст быстрее пары новых DGX Spark за $13 900. Автор проверил замеры Джуна Ямога: четыре V100 с NVLink и 128 ГБ памяти выдают 155 токенов в секунду на Qwen 3.8 Flash Next (125B), тогда как два DGX Spark на Blackwell с NVFP4 — около 60. Причина не в вычислительной мощности, а в памяти: V100 имеет 900 ГБ/с против 273 ГБ/с у Spark, и при генерации токенов узким местом становится именно пропускная способность, а не тензорные ядра. Ещё показательнее сравнение с сервером Алекса Зискинда на восьми RTX Pro 6000 Blackwell за $120 000: он выдал 126 токенов/с, медленнее четырёх V100, потому что PCIe-шина при добавлении карт стала бутылочным горлышком, тогда как NVLink у V100 работает на 300 ГБ/с. Скорость держится на свежем опенсорсном форке OneCat VLM: между первой версией и релизом от 3 октября те же карты ускорились с 49 до 201 токена в секунду, то есть на 310%, без изменения железа. Экономика неоднозначна: при мощности 700 Вт и цене электричества 18 центов за кВт·ч генерация миллиона токенов обходится в 23 цента, вдвое дешевле API Alibaba за 47 центов, но для окупаемости $3500 нужно сгенерировать 14,5 миллиарда токенов, что при 8 часах в день займёт 9 лет. Официальная поддержка V100 уже закончилась в CUDA 13, последний драйвер будет поддерживаться лишь до середины 2028 года, поэтому будущее зависит от небольшого сообщества на GitHub, а не от Nvidia.
Практика
- Что получишь
- Поймёте, почему старые серверные V100 с большой памятью обгоняют новые DGX Spark на генерации текста и когда такая покупка экономически оправдана. Сможете прикинуть окупаемость своей локальной фермы с учётом цены электричества и сроков поддержки драйверов.
- Первый шаг
- Прежде чем покупать V100, посчитайте свою цену за кВт·ч и оцените, сколько миллионов токенов в день вы реально генерируете, а затем сравните с API за 47 центов.
- Цифры
- —155 против 60 токенов в секунду — скорость генерации текста у четырёх V100 и двух DGX Spark в тесте Джуна
- —900 ГБ/с против 273 ГБ/с — пропускная способность памяти V100 и DGX Spark, объясняющая разницу
- —14,5 миллиарда токенов — сколько нужно сгенерировать, чтобы V100-сборка за $3500 окупилась за счёт разницы с облачным API
- —До середины 2028 года — срок официальной поддержки финального драйвера Nvidia для V100
- Честно
- Конкретных инструкций по сборке нет: автор разбирает чужие замеры и не показывает свою сборку стенда. В видео нет прямой рекламы или партнёрских ссылок, но в конце автор просит подписаться на канал.
Если слова незнакомы — 7 терминов
- токенединица текста, которую модель генерирует или читает за один шаг
- NVLinkвысокоскоростное соединение между GPU от Nvidia
- PCIeстандартная шина подключения карт к материнской плате
- тензорные ядрааппаратные блоки в GPU для ускорения матричных вычислений
- форкответвление открытого проекта, развиваемое отдельно от оригинала
- CUDAпрограммная платформа Nvidia для вычислений на GPU
- APIинтерфейс, через который можно отправлять запросы к облачной модели
Связки из этого ролика
3 шт.- 4x Nvidia Tesla V100 SXM2 via NVLink
- 2x Nvidia DGX Spark Founders Edition
- 8x Nvidia RTX Pro 6000 Blackwell Server Edition
Компоненты
12 шт.Формат: мнение · для практикующих · уверенность разметки 0.9 · источник