Kimi K3.1 Pro: цена размера и отказ от кибер-тем
Что в ролике
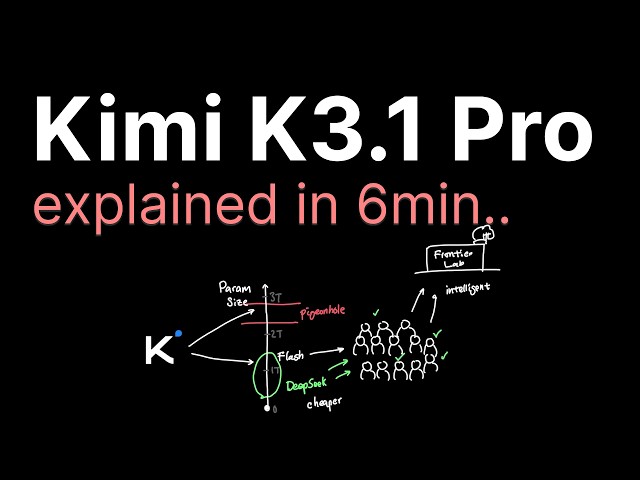
В условиях острой нехватки GPU-мощностей Moonshot представила Kimi K3.1 на 2,8 трлн параметров — крупнейшую открытую модель, которую практичнее запускать на Blackwell-чипах B200/B300, а не на H100/H200. Обучение нового чекпоинта заняло три месяца, и почти весь прирост относительно K3 получен пост-тренингом: по оценкам, к 2026 году более 50% вычислительного бюджета передовых лабораторий уходит на пост-тренинг и reinforcement learning, а 11-балльный скачок в агрегированных бенчмарках стоил примерно 15% дополнительной токен-генерации. Автор подчёркивает, что Moonshot осознанно убрала данные по кибербезопасности из mid-training и post-training, сделав модель слабее в этой области, чтобы снизить риски при распространении открытых весов. Этот шаг он ставит в контекст недавнего инцидента OpenAI с Hugging Face, когда именно открытая GLM помогла разобрать логи после отказа закрытых моделей. Дистрибуция такой модели остаётся узким местом: инференс-провайдеры в основном американские, а нагрузка на экосистему растёт. Веса Kimi K3.1 Pro обещают открыть к 4 ноября, а слово Pro в названии намекает на будущую Flash-версию, которая может помочь Moonshot выйти из неудобного положения между дешёвым DeepSeek и лидирующими закрытыми Opus и GPT-6.
Практика
- Что получишь
- Поймёте, почему большие открытые модели упираются в дефицит GPU, как пост-тренинг смещает бюджеты лабораторий и зачем Moonshot сознательно ограничила кибербезопасность. Сможете оценить, стоит ли ждать Kimi K3.1 Pro для своих задач или дождаться Flash-версии.
- Первый шаг
- Начать с изучения бенчмарков Artificial Analysis и сравнения Kimi K3.1 с K3 по скорости и цене токена у инференс-провайдеров.
- Цифры
- —2,8 трлн параметров — размер Kimi K3.1 Pro, из-за которого модель выгоднее запускать на Blackwell B200/B300, а не на H100/H200
- —11 баллов — прирост Kimi K3.1 в агрегированных бенчмарках по сравнению с K3
- —15% — на столько в среднем выросла токен-генерация, обеспечившая этот прирост
- —50% — доля вычислительного бюджета передовых лабораторий, которая по оценке к 2026 году уйдёт на пост-тренинг и RL
- Честно
- Автор не продвигает свои продукты, курс или партнёрские ссылки, ролик аналитический. Ключевые графики SemiAnalysis и Artificial Analysis показаны только на экране, поэтому цифры по ценам GPU и бюджетам пост-тренинга придётся проверять в этих источниках. Готовых команд и инструкций нет, материал для понимания индустрии, а не для повторения.
Если слова незнакомы — 6 терминов
- пост-тренингэтап дообучения модели после предобучения, где улучшают способности через RL и специальные данные
- reinforcement learningобучение модели методом проб и ошибок с наградой за правильные действия
- инференс-провайдерысервисы, предоставляющие доступ к модели через API
- открытые весапараметры модели, доступные для скачивания и запуска без ограничений
- Blackwell-чипы B200/B300новое поколение GPU Nvidia, более эффективное для запуска больших моделей, чем Hopper H100/H200
- Flash-версияоблегчённая и более дешёвая версия модели, ориентированная на массовое использование
Компоненты
17 шт.Формат: реакция на новость · для продвинутых · уверенность разметки 0.9 · источник