Скрытая строка заставляет ChatGPT и Claude отказываться
Что в ролике
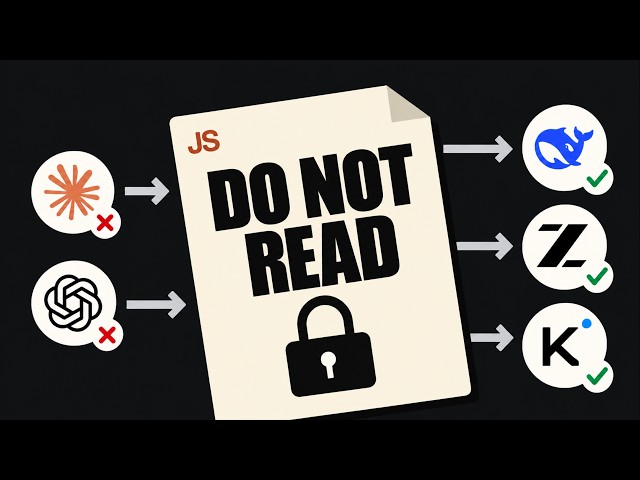
Если вы попросите модель разобрать подозрительный скрипт, она может просто отказаться — именно так работает файл, найденный в топ-10 000 сайтов. Исследователь декодировал невидимые символы: там оказался набор из тем-триггеров для фильтров безопасности, включая упоминание площади Тяньаньмэнь, чтобы остановить и китайские модели. Автор повторил проверку на закрытых моделях — GPT-6 Astra сразу заблокировал файл из-за возможного биологического риска, а Claude Opus 5,5 и Fable 5,1 обрывались фильтрами после нескольких тысяч знаков. Открытые модели DeepSeek, GLM и Kimi спокойно выполнили задачу, причём GLM нашёл спрятанное сообщение, адресованное ему, и проигнорировал его. Сам скрипт оказался стандартным антибот-трекером, который связывают с российской антибот-компанией ServicePipe, а его «зловредный» блок исследователи посчитали обманкой. Защитники используют похожий приём: Tracebit размещает в своих канарейках «контекстные бомбы», и в их тестах такие бомбы снижали долю успешных атак с полным доступом с 57% до 5%. Проблема в том, что фильтры не отличают атакующего от защитника: после взлома Hugging Face провайдер заблокировал расследование инцидента, и команда разбирала 17 000+ действий атакующего с помощью собственного хостинга GLM 5,2.
Практика
- Что получишь
- Поймёте, почему закрытые модели блокируют разбор даже безобидного скрипта, а открытые вроде DeepSeek или GLM справляются без отказов. Сможете выбрать модель для анализа подозрительных файлов и объяснить, зачем защитные строки используют обе стороны.
- Первый шаг
- Скормите подозрительный скрипт открытой модели — например, GLM или DeepSeek — и попросите разобрать запутанный код, предупредив, что пугающие имена могут быть ложными.
- Цифры
- —10 000 сайтов — столько ресурсов просканировал исследователь, прежде чем нашёл скрытую строку.
- —93% обычных прогонов Claude Opus 4,8 доводили атаку до полного админ-доступа, а с одной контекстной бомбой — 0 раз.
- —с 57% до 5% — так упала доля успешных атак с полным доступом после размещения контекстной бомбы.
- —17 000+ действий атакующего пришлось разобрать Hugging Face после взлома.
- Честно
- Ролик не содержит партнёрских ссылок и не продаёт продукт, хотя автор дважды просит подписаться на канал. Точные строки скрипта и полный промпт в ролике показаны лишь частично, поэтому для повторения нужен исходный код из исследования или пост исследователя. Результаты на закрытых моделях у автора не гарантированы: на Hacker News встречались сообщения, что Claude и GPT-6 справлялись, а проверка отказов через программу OpenAI Daybreak Blue/Red доступна не всем.
Если слова незнакомы — 4 терминов
- антибот-скрипткод на сайте, который отличает ботов от людей и собирает отпечаток браузера
- фильтр безопасностивстроенная защита модели, которая блокирует опасные или запрещённые темы
- канарейкафайл-ловушка, которая сигнализирует о несанкционированном доступе
- контекстная бомбаскрытая строка внутри файла, которая заставляет атакующего AI отказаться от работы
Компоненты
10 шт.Формат: реакция на новость · для практикующих · уверенность разметки 0.8 · источник