MOSS Image: 5B-модель с точным размещением текста
Что в ролике
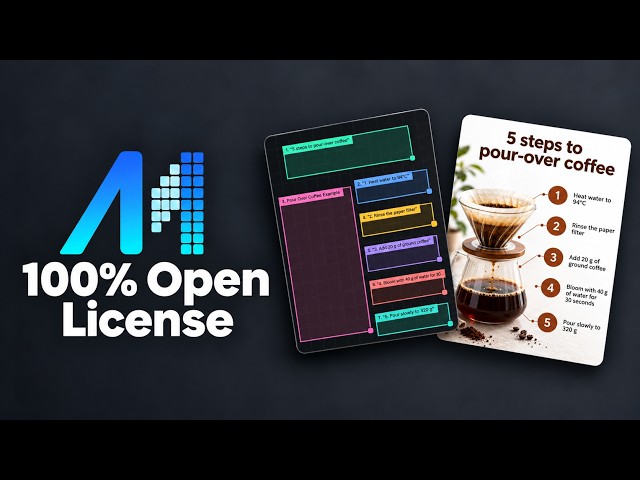
Если нужны изображения с точным текстом и размещением объектов, модель MOSS Image от Open MOSS интересна лицензией Apache 2.0: весами и кодом можно распоряжаться как угодно, включая коммерцию и NSFW. Это диффузионный трансформер на 5 млрд параметров, обученный с нуля, с текстовым энкодером Qwen 3.5 на 9 млрд параметров, который принимает промпты до 4000 токенов. Автор показывает на SFT-модели в VLM Omni: фотореалистичные портреты, продуктовые кадры, стили и соотношения сторон от 0,25 мегапикселя до 4 мегапикселей, с оптимумом 1–2 мегапикселя. Главная сила — генерация текста: от одной строки до трёхстрочных постеров, меню и инфографики на английском и китайском, при этом на внутреннем бенчмарке Open MOSS модель обходит другие открытые аналоги и почти догоняет Nano Banana и GPT Image 2. Ключевая фича — JSON-раскладка: сцена описывается вместе с bounding box для каждого элемента, и модель старается разместить объекты и текст именно там, а LLM может писать такой JSON автоматически. Из ограничений: модель не умеет редактировать существующие изображения (только text-to-image и стандартный inpainting в ComfyUI), а слишком много слов на странице может ломать текст. Для ускорения генерации с примерно 30 секунд сообщество уже выпустило 8-шаговые и 4-шаговые LoRA, квантованные версии и файнтюны, а сама команда обещает официальную дистилляцию.
Практика
- Что получишь
- Сможете генерировать изображения с предсказуемым расположением текста и объектов через JSON-раскладку, а при необходимости — использовать веса и код модели в коммерческом продукте благодаря Apache 2.0.
- Первый шаг
- Скачайте SFT-модель MOSS Image с Hugging Face и запустите её в ComfyUI, затем опишите сцену с bounding box в JSON и сгенерируйте первый постер.
- Цифры
- —5 млрд параметров — размер самой модели MOSS Image
- —9 млрд параметров — размер текстового энкодера Qwen 3.5, который читает промпт
- —4000 токенов — максимальная длина промпта, которую принимает модель
- —30 секунд — примерно столько занимает генерация без LoRA на оборудовании автора
- Честно
- Бенчмарк, по которому модель обходит конкурентов, — собственный от Open MOSS, независимых замеров пока нет. Детали JSON-раскладки и интерфейс галереи автор показывает на экране, в речи они не расшифрованы. Рекламы продуктов нет, но в конце автор просит лайк и подписку.
Если слова незнакомы — 10 терминов
- диффузионный трансформерархитектура генерации изображений, которая постепенно превращает шум в картинку
- промпттекстовое задание, которое ты пишешь модели
- токенединица текста, на которые модель разбивает промпт
- SFT-модельверсия после supervised fine-tuning, готовая к генерации по инструкциям
- bounding boxпрямоугольная область на изображении, задающая позицию элемента
- LLMбольшая языковая модель, например GPT или Qwen
- LoRAнебольшая дообученная надстройка, меняющая стиль или ускоряющая модель
- файнтюндообучение модели на дополнительных данных
- inpaintingзамена только выделенной области изображения
- NSFWконтент, который не принято открывать на работе, например откровенные материалы
Связки из этого ролика
3 шт.- Moss image + ComfyUI
- Moss image + LoRA
- Moss image + Qwen
Компоненты
7 шт.Формат: обзор · для практикующих · уверенность разметки 0.85 · источник