Почему модель на 17 ГБ не запустилась на ноутбуке
Что в ролике
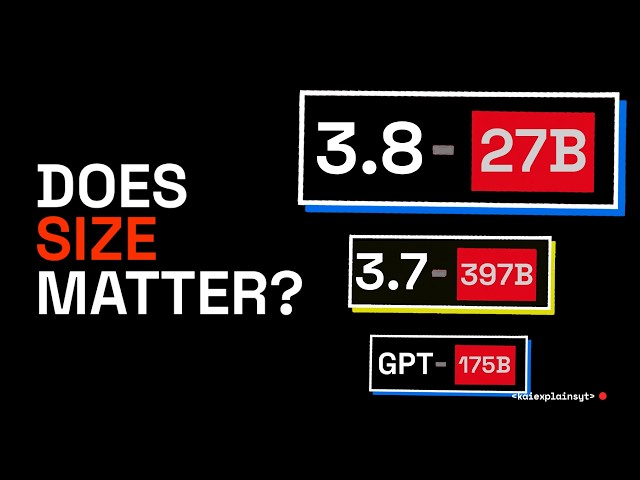
Автор скачал модель Qwen3 27B весом 17 ГБ в надежде на длинную сессию кодинга и получил нехватку памяти на ноутбуке, потому что читал не тот счётчик. Уменьшилось число активных параметров — тех, что умножаются на каждом токене: с 175 млрд у GPT-3 до 5–6 млрд сейчас, то есть вычисления на слово подешевели примерно в 30 раз за пять лет. Но все остальные эксперты обязаны лежать в памяти до того, как роутер выберет нужного: у модели 384 эксперта, из которых на каждом токене работают шесть. Второй счёт в этой истории — контекст: 262 000 токенов превращаются в KV-кэш примерно на 16 ГБ рядом с 17 ГБ весов, и спасает только то, что из 64 слоёв лишь 16 держат растущую память, а 48 используют фиксированную. Без этой хитрости контекст занял бы 64 ГБ, и модель просто не существовала бы на настольной машине. С бенчмарками та же проблема: 61,7 балла на SWE-bench Pro против Claude Opus получены в собственной обвязке Qwen, а Opus в той же таблице выигрывает на Terminal-Bench и на GPQA Diamond. Ещё нагляднее второй пример: у Qwen3 Next 6 млрд активных параметров при 180 млрд общих, а квантизованный файл занимает 111 ГБ на четырёх шардах и требует 110 ГБ системной памяти. Отдельная статья расходов — пресет reasoning effort: low и medium отстают от максимума на пару баллов, но тратят в семь раз меньше токенов и времени, а на 26 задачах самый дорогой режим прошёл тестов меньше, чем средний.
Практика
- Что получишь
- Научитесь спрашивать не «сколько там параметров», а три вещи: сколько памяти нужно до первого слова, сколько добавляет каждый токен контекста и сколько токенов модель тратит на размышления.
- Первый шаг
- Открыть настройку reasoning effort в своём клиенте и опустить её с максимума на low или medium — это самая быстрая экономия, доступная прямо сейчас.
- Цифры
- —16 ГБ — столько памяти требует контекст на 262 000 токенов, то есть примерно столько же, сколько сами веса на 17 ГБ
- —384 эксперта в модели, из которых на каждом токене работают 6 — поэтому остальные всё равно должны лежать в памяти
- —111 ГБ — квантизованный файл Qwen3 Next с 6 млрд активных параметров: он шёл на 24 ГБ карте вместе со 110 ГБ системной памяти
- —$2,65 и $9,77 за задачу — низкий и максимальный reasoning effort на 26 задачах, при 21 и 24 пройденных тестах: максимум дороже и хуже среднего
- Честно
- Рекламы и спонсоров в ролике нет, но и повторяемых действий тоже: это разбор с расчётами, а не инструкция. Все цифры автор берёт из документации и постов сообщества, сам замеров не делал, а вывод про бенчмарки — его собственная интерпретация сносок. Полезно знать, что автосубтитры сильно искажают названия: Qwen3 звучит как Quinn, Anthropic как Entropic, поэтому искать упомянутые модели и статьи придётся по звучанию.
Если слова незнакомы — 9 терминов
- активные и общие параметрычисло весов модели: активные работают на каждом слове, общие все лежат в памяти
- эксперты (MoE)архитектура, где модель состоит из множества узких экспертов, а на каждом слове включается лишь несколько
- KV-кэшпамять, в которой модель держит весь предыдущий разговор, чтобы возвращаться к нему
- токенкусочек текста, которым модель считает вход и выход
- контекствесь текст, который модель держит перед собой во время разговора
- квантизациясжатие весов модели: файл меньше, но качество может падать
- reasoning effortнастройка, задающая, сколько модель размышляет перед ответом
- бенчмаркнабор тестовых задач, по которому сравнивают модели
- обвязка (харнесс)программа-обёртка, через которую модель получает задачи и инструменты
Связки из этого ролика
4 шт.- Qwen3 27B + KV-кэш — 262k токенов контекста стоят ещё ~16 ГБ памяти рядом с 17 ГБ весов, поэтому модель не влезает на домашнюю машину
- Qwen3 Next + одна 24 ГБ видеокарта — 6B активных параметров при 180B общих оборачиваются 111 ГБ квантизованного файла и 110 ГБ системной RAM
- reasoning effort + API-биллинг — пресеты low/medium дают почти тот же результат, что high/extra high, но в разы дешевле по токенам и времени
- MoE + собственный сервер — архитектура выгодна там, где память уже куплена, и KV-кэш на сессию позволяет умещать больше разговоров на карту
Компоненты
10 шт.Формат: разбор · для практикующих · уверенность разметки 0.85 · источник