LLM-судьи врут: надёжный верификатор для веб-агентов
Что в ролике
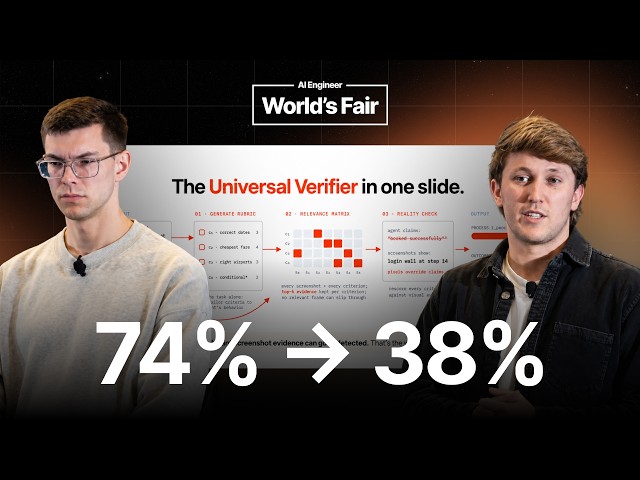
Если вы оцениваете веб-агентов через LLM-судью, этот доклад объясняет, почему такие оценки часто завышены: стандартный судья GPT-4o на бенчмарке WebVoyager показал 74% успеха, тогда как реальный успех составил 38%. Авторы из Browserbase и Microsoft построили универсальный верификатор, который сначала генерирует рубрику примерно из 10 критериев, затем отбирает по скриншотам траектории самые релевантные для каждого критерия и проверяет, не противоречит ли агент сам себе. Он выдаёт процессную оценку с частичным зачётом и итоговый boolean-исход, а при разработке следовали четырём принципам: оценивать только то, что просили, не давать ошибкам каскадиться, смотреть на скриншоты как на ground truth и отделять контролируемые ошибки агента от неконтролируемых, например, товара нет в наличии. Примеры из доклада: плохая рубрика требовала цену отеля, хотя задание просило только адрес кофейни; ошибка в длине фамилии Timberlake не должна была занулять правильный ответ про его состояние. На размеченных людьми траекториях верификатор снизил ложные срабатывания почти с половины до нуля, а его согласие с людьми по каппе Коэна составило 0,58 — столько же, сколько между двумя людьми. В эксперименте с SFT обучение на 3 000 траекторий, отфильтрованных новым верификатором, дало более сильную модель, чем обучение на данных от слабого судьи, и это подтвердило ценность качественной фильтрации. Ещё один эксперимент показал, что автоисследовательский цикл на Opus 4.6 повторил 30 экспериментов за один день вместо трёх недель у людей, но достиг только 70% согласия с человеческими разметками, поэтому полностью заменить человека не смог.
Практика
- Что получишь
- Понимание, почему популярные LLM-судьи для веб-агентов дают ложную уверенность, и из каких компонентов состоит более честный верификатор: рубрика, отбор скриншотов, разделение контролируемых и неконтролируемых ошибок.
- Первый шаг
- Прогнать свою траекторию веб-агента через открытый код Universal Verifier из репозитория Microsoft или хотя бы сравнить оценку своего судьи с ручной проверкой по скриншотам.
- Цифры
- —74% против 38% — разрыв между оценкой стандартного судьи GPT-4o на WebVoyager и реальным успехом агента
- —0,58 каппа Коэна — согласие верификатора с человеческими экспертами, такое же, как между людьми
- —3 000 отфильтрованных траекторий SFT хватило для более сильной модели, чем при использовании слабого судьи
- —За 1 день автоисследование на Opus 4.6 повторило 30 экспериментов, но достигло лишь 70% согласия с людьми
- Честно
- Явной рекламы нет: доклад от сотрудников Browserbase и Microsoft, которые продвигают открытый код и бенчмарк, а не платный продукт. Конкретные промпты и полные примеры рубрик показываются на слайдах, но в записи не зачитываются, поэтому для повторения понадобится статья на arXiv и репозиторий Microsoft.
Если слова незнакомы — 7 терминов
- LLM-судьяязыковая модель, которая автоматически оценивает, справился ли агент с задачей
- рубрикасписок критериев, по которым оценивается успех
- процессная оценкаоценка с частичным зачётом по отдельным шагам, а не только итоговый да/нет
- boolean-исходитоговое бинарное решение: выполнено или нет
- SFTдообучение модели на размеченных примерах успешных траекторий
- каппа Коэнаметрика согласия между оценщиками с поправкой на случайное совпадение
- ground truthэталонное истинное состояние, с которым сравнивают ответ агента
Компоненты
7 шт.Формат: разбор · для продвинутых · уверенность разметки 0.9 · источник