Как очистить 80 000 файлов для точного AI-чат-бота
Что в ролике
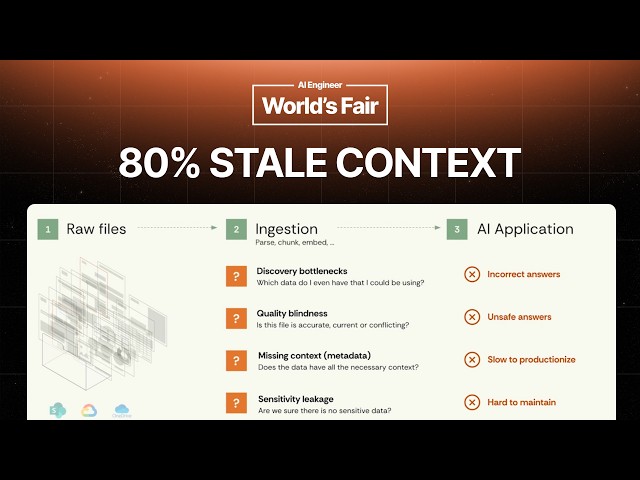
Компания North River Manufacturing с 40 000 сотрудников и миллионами документов в SharePoint хочет запустить legal-ops чат-бота, отвечающего по контрактам и соглашениям в реальном времени. Пилот на 40 файлах с парсингом, OCR, эмбеддингами и векторной базой работал, но при переходе к 80 000+ файлов появились дубликаты, устаревшие версии и неясно, где чувствительные данные, поэтому в DZ автоматизировали разметку и фильтрацию. В демо из 339 файлов приложение DZ построило таксономию тегов, AI предложил метаданные и категории, а фильтры свели выборку до 20 релевантных контрактов с объяснением, почему именно эти файлы подходят. Для чувствительности сканируются PII и PHI паттернами с контекстом и AI, причём на конференции в Лондоне система сама определила синтаксис финского национального ID и добавила связанные финские слова. Качество оценивается по дублям, конфликтам и свежести, после чего под конкретный сценарий формируется data slice: в одном примере это 14 юридических файлов с готовым контекстом для чат-бота. Метаданные автоматически обновляются по расписанию через Workflows и SDK, чтобы чат-бот не устаревал и находил новые или удалённые файлы из SharePoint. На тех же задачах многошагового RAG-чата предварительная очистка от дублей и устаревших данных удвоила recall@1 и подняла точность выполнения задач на 10–15%, а если 30% файлов мусорные, то до 80% контекста агента занимают устаревшие фрагменты.
Практика
- Что получишь
- Поймёте, как автоматически отбирать документы, чистить дубликаты и устаревшие версии, размечать чувствительные данные и поддерживать метаданные чат-бота актуальными.
- Первый шаг
- Взять свою SharePoint-библиотеку с документами и в DZ создать таксономию с нужными тегами, запустив автоподсказки AI.
- Цифры
- —80 000+ файлов — с таким объёмом SharePoint-документов North River начинаются проблемы поиска, дублей и чувствительных данных
- —339 файлов в демо DZ, из которых фильтры оставили 20 релевантных юридических документов
- —30% устаревших или дублирующихся файлов могут занять до 80% контекста агента
- —2 раза — рост recall@1 на задачах RAG-чата после очистки, плюс 10–15% к точности
- Честно
- Это презентация вендора DZ Labs, которую купила Calibbra, в конце предлагают бесплатный недельный POC и зовут на стенд. Все демо показывают интерфейс DZ, команды и настройки видны только на экране, готового кода в транскрипте нет. Цифры по улучшению recall и точности — внутренние оценки компании, а не независимый бенчмарк.
Если слова незнакомы — 8 терминов
- RAGподход, при котором ассистент сначала ищет нужные куски документов, а потом отвечает по ним
- recall@1доля случаев, когда нужный документ оказался первым в выдаче поиска
- data sliceготовый набор отобранных и размеченных файлов под конкретный сценарий
- таксономиядерево тегов или категорий, по которому распределяются документы
- PIIперсональные данные, по которым можно идентифицировать человека
- PHIмедицинские данные, относящиеся к здоровью человека
- эмбеддингивекторные представления текста, по которым ищут похожие смыслы
- OCRраспознавание текста в сканах и картинках
Связки из этого ролика
5 шт.- RAG
- vector database
- knowledge graph
- OCR
- metadata tagging
Компоненты
4 шт.Формат: пошаговый урок · для практикующих · уверенность разметки 0.85 · источник