Бенчмарк болтливости ИИ: кто отвечает короче
Что в ролике
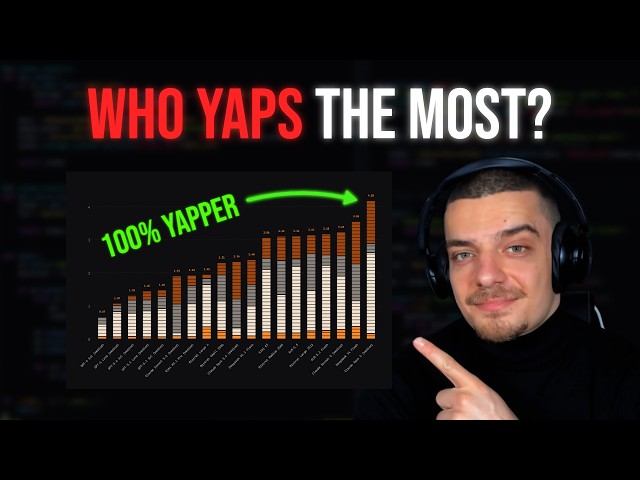
Если вас раздражает, когда модель отвечает простынёй с «вы абсолютно правы» и длинными тире, NeuralNine собрал собственный бенчмарк Neural Yap, чтобы измерять именно это. Он разделил оценку на четыре категории: типичные фразы, типографика, форматирование и длина ответа, а в репозитории на GitHub хранятся промпты и регулярные выражения для наказания болтовни. Результаты удивили автора: модели GPT набрали меньше всех баллов, то есть болтали меньше, чем модели Claude, которые он считал приятными. Самым болтливым оказался Claude Opus 5, а Mistral Large 4 и DeepSeek V4 Flash особенно злоупотребляют типичными AI-фразами. Прогон Kim E K3 стоил 18,53 доллара против менее доллара у большинства моделей, а повторный запуск Pro-версии обошёлся в 1,10 доллара. Автор объясняет расхождение с личным опытом тем, что системные инструкции и среда запуска (Claude Code против Codex) влияют сильнее, чем сама модель, и планирует учесть это в версии 0,2.
Практика
- Что получишь
- Поймёте, какие модели отвечают короче и без типичных AI-фраз, а также увидите методику оценки болтовни по четырём категориям — от длины до форматирования.
- Первый шаг
- Собрать несколько своих типовых промптов и вручную проверить ответы на длину, фразы «вы правы», длинные тире и маркдаун-структуру, как это делает бенчмарк.
- Цифры
- —4 — столько категорий болтовни в бенчмарке: фразы, типографика, форматирование, длина
- —18,53 доллара — столько стоил прогон Kim E K3, тогда как большинство моделей уложились меньше чем в доллар
- —1,10 доллара — столько стоил прогон Kim E K3.1 Pro
- —250 слов — допустимый лимит для ответов с кодом, после которого модель наказывают за длину
- Честно
- Репозиторий Neural Yap в момент записи приватный, поэтому готовый код и полные результаты по всем моделям недоступны; автор обещает открыть его, только если зрители попросят. В конце ролика он рекламирует свои услуги фрилансера и консультанта через вкладку Services на сайте. Часть результатов показана только на экране, в пересказе всех чисел нет.
Если слова незнакомы — 4 терминов
- бенчмарксравнительный тест, где модели выполняют одинаковые задания и получают числовую оценку
- промпттекст-задание, которое отправляют модели
- регулярные выраженияшаблоны для поиска и наказания конкретных слов и конструкций в тексте
- системные инструкциислужебные указания, которые задают стиль ответов модели до диалога
Понадобится экран
Часть информации есть только на экране (код в терминале). Открыть на YouTube с 4:10.
Связки из этого ролика
3 шт.- Claude Code
- Codex
- Claude.ai
Компоненты
12 шт.Цитаты-доказательства
дословно из субтитров- So, this is the GitHub repository on my system, and what we have here is a bunch of different directories that are all relevant.4:10
- So, here we have all the different patterns, all the phrases that we're punishing, stuff like let's dive in or "Ah, I see the issue now." or "You're right. You're absolutely, totally, completely right."4:24
- And all of this ends up in the results directory. Of course, we have the images that we took a look at, but we also have a result CSV file, and this one also shows something that we cannot see in the graph.6:40
Формат: сборка на живом примере · для практикующих · уверенность разметки 0.85 · источник