Как устроена CUDA: память, потоки и экосистема
Что в ролике
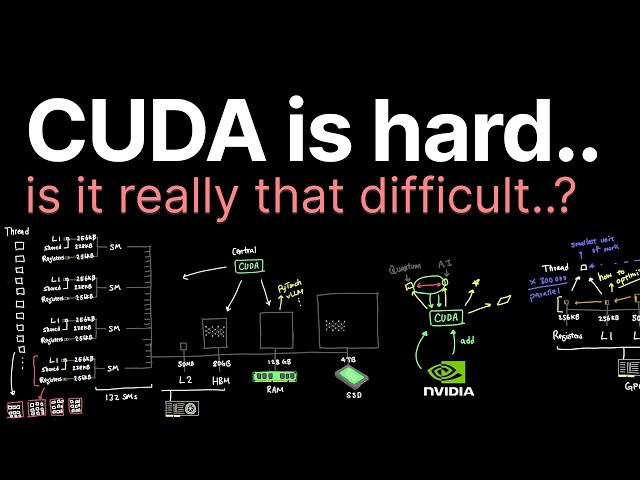
Если вы запускали модель локально, веса сначала лежат на SSD, а потом движок на CPU тянет их в HBM видеокарты — и внутри GPU такой же каскад памяти: 80 ГБ HBM, 50 МБ L2, 256 КБ регистров и 228 КБ общей памяти. На примере матричного умножения на 100 млн операций автор показывает, как работа делится на 132 потоковых мультипроцессора (SM), каждый на 4 варпа по 32 потока, и при тактовой частоте 1,5 ГГц это теоретически укладывается в 2 микросекунды. CUDA здесь — место встречи железа и софта: тысячи потоков конкурируют за общую память, поэтому под разные задачи пишут сотни и тысячи разных ядер, от cuBLAS для линейной алгебры до cuDNN для глубокого обучения. Затем автор расширяет картину: CUDA — не просто библиотека, а платформа с компилятором в промежуточный PTX, рантаймом и драйвером, что позволяет переносить код между поколениями Nvidia GPU. Отдельно упоминаются надстройки вроде Triton от OpenAI и FlashAttention, которые работают поверх CUDA, но не входят в ядро. В конце Стивен Джонс, работающий с CUDA с 2008 года, объясняет, почему Nvidia постоянно наблюдает за индустрией и забирает в ядро то, что повторяется у разных групп разработчиков.
Практика
- Что получишь
- Понимание иерархии памяти GPU и того, как CUDA связывает железо и софт, чтобы осознанно выбирать или писать ядра под свои задачи.
- Первый шаг
- Вернуться к разбору матричного умножения в ролике и повторить расчёт: 100 млн операций делятся на 132 SM, 4 варпа и 32 потока.
- Цифры
- —100 млн операций — размер одного матричного умножения, которое GPU теоретически выполняет за 2 микросекунды
- —132 SM и 4 варпа по 32 потока — на столько параллельных блоков автор делит работу
- —80 ГБ HBM, 50 МБ L2 и 256 КБ регистров — каскад памяти, который сужается по мере приближения к потоку
- —1,5 ГГц — тактовая частота GPU, при которой 3000 циклов дают примерно 2 микросекунды
- Честно
- Ролик спонсирует Tripo: сегмент про Charakru и автоматизацию 3D-персонажей в Blender — это реклама, автор даёт партнёрскую ссылку с 500 бонусными кредитами и скидкой 60% на первый месяц планов Pro/Max. Основная часть про CUDA не рекламная, но конкретные команды и код в ролике не показаны, а полное интервью со Стивеном Джонсом выйдет отдельным видео.
Если слова незнакомы — 9 терминов
- HBMбыстрая память на графическом чипе, где во время работы лежат веса модели
- SMпотоковый мультипроцессор, блок GPU, который исполняет тысячи потоков параллельно
- warpгруппа из 32 потоков, которые выполняют одну инструкцию одновременно
- PTXпромежуточный код CUDA, который компилятор переводит под конкретную архитектуру GPU
- kernelфункция, которую GPU запускает на множестве потоков для выполнения одной задачи
- cuBLASбиблиотека CUDA для быстрых операций линейной алгебры, например умножения матриц
- cuDNNбиблиотека CUDA для свёрточных нейросетей и других операций глубокого обучения
- Tritonязык и компилятор от OpenAI для написания GPU-ядер на более высоком уровне, чем CUDA
- FlashAttentionалгоритм эффективного внимания для трансформеров, ускоряющий работу с большими последовательностями
Компоненты
9 шт.Формат: разбор · для новичков · уверенность разметки 0.85 · источник