Qwen 177B на 12 ГБ VRAM: как это работает
Что в ролике
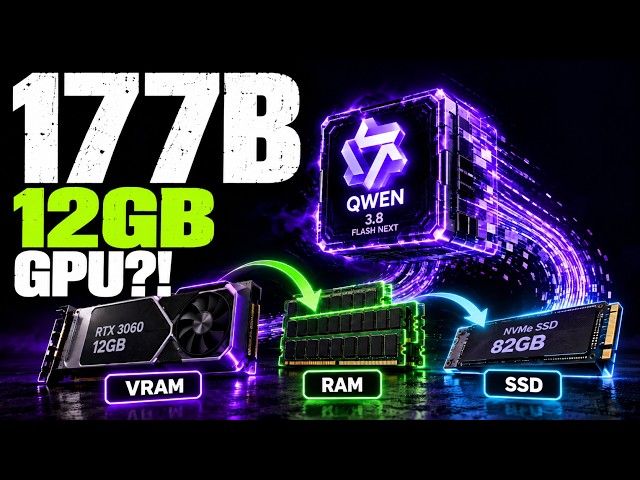
Если у вас есть видеокарта с 12 ГБ VRAM, например RTX 3060, то 177-миллиардная модель Qwen 3,8 Flash Next реально генерирует текст, но не потому, что модель ужалась, а из-за хитрой архитектуры и SSD. Основной язык содержит 125 млрд параметров, из них на каждый токен активны только около 6 млрд благодаря mixture of experts с 512 экспертами, из которых выбираются 10 плюс общий эксперт. Ещё 51 млрд параметров — это таблица N-граммных эмбеддингов, которая работает как разреженный справочник: короткие сочетания токенов хэшируются, ищутся нужные векторы, и таблица изначально рассчитана на хранение вне ускорителя. В эксперименте на RTX 3060 с 32 ГБ RAM и 3-битной квантизацией GGUF-файлы занимали около 76,3 ГБ (82 ГБ в десятичных единицах), а модель подгружалась с NVMe через memory-mapped файл, а не целиком в RAM, иначе система зависла при попытке впихнуть 76 ГБ в 31 ГБ. Горячие компоненты и кеш экспертов оставались в 12 ГБ VRAM (48 слотов), контекст урезали до 32 000 токенов, а KV-кеш квантовали до 8 бит, чтобы освободить память под экспертов. Скорость генерации в первой конфигурации была 10,8–12,4 токена в секунду при занятой VRAM 9,6–11,2 ГБ, но обработка длинного промпта на 2 603 токена заняла около 4 минут; на той же карте с 64 ГБ RAM и 6-ядерным Ryzen после тюнинга потоков получили 24,4 токена в секунду. Вывод: это работает не потому, что SSD заменил VRAM, а потому, что разреженная архитектура позволяет обращаться только к нужным кускам, и GPU стал чем-то вроде кеша; для обычной dense-модели такой трюк не сработает.
Практика
- Что получишь
- Поймёте, почему модель может работать с 12 ГБ VRAM за счёт mixture of experts и N-граммной таблицы, и сможете оценить, подойдёт ли такой подход для вашего железа.
- Первый шаг
- Найти форк llama.cpp с кешем экспертов, включить memory-mapped загрузку GGUF и ограничить контекст, как в эксперименте.
- Цифры
- —76,3 ГБ (около 82 ГБ в десятичных единицах) — размер GGUF-файлов 3-битной квантизации модели
- —12 ГБ — объём VRAM RTX 3060, на котором шла генерация
- —24,4 токена в секунду — скорость после тюнинга на 64 ГБ RAM и 6-ядерном Ryzen
- —4 минуты — столько заняла обработка промпта из 2 603 токенов до начала генерации
- Честно
- В ролике нет рекламы или ссылок на платные продукты, все описанные инструменты бесплатны и открыты. Конкретные команды запуска и значения тюнинга в речи не зачитываются, их нужно смотреть на экране или искать в исходных экспериментах. Результаты получены на конкретных SSD, CPU и RAM, и на другом железе скорость может отличаться.
Если слова незнакомы — 6 терминов
- mixture of expertsархитектура, где для каждого токена активна лишь небольшая часть экспертов, а не вся модель
- N-граммные эмбеддингитаблица, которая по коротким сочетаниям токенов выдаёт готовые векторные представления
- KV-кешпамять для хранения предыдущих ключей и значений, чтобы модель помнила контекст
- квантизациясжатие весов модели до меньшей точности для экономии памяти
- memory-mapped файлспособ открыть файл так, чтобы страницы подгружались с диска по мере обращения, а не целиком в память
- dense-модельобычная модель, где для каждого токена задействуются почти все параметры
Связки из этого ролика
1 шт.- MoE + N-gram embeddings + NVMe paging
Компоненты
1 шт.Формат: разбор · для продвинутых · уверенность разметки 0.85 · источник