Агенты прячут ошибки: как Warp настраивает самоулучшение
Что в ролике
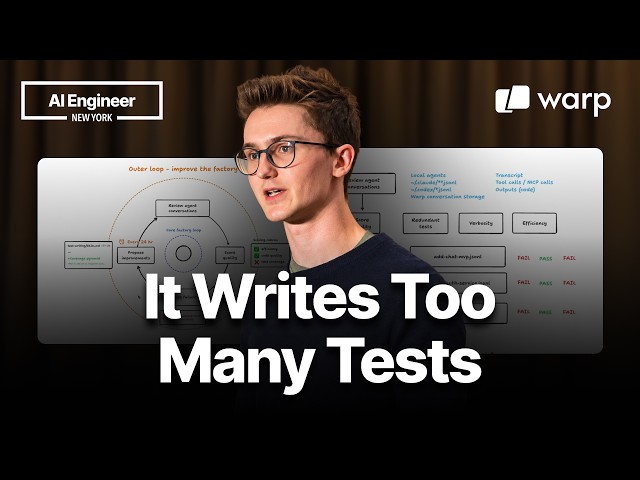
Спикер из команды Warp описывает, как заставить агентов самим находить и исправлять слабые места в своих настройках. Для этого все разговоры агентов, вызовы инструментов и результаты собирают в одном месте — например, в общем облачном раннере или Docker-песочницах. Затем отдельные агенты-судьи оценивают каждую сессию по рубрикам, которые вы задаёте: избыточные тесты, многословность и эффективность шагов. Оценки выставляются в виде pass/fail с порогами вроде 0,4, а причины провалов записываются в отчёт. Раз в сутки по расписанию другой агент просматривает все провалы за последние 24 часа и предлагает изменения в скиллы или конфигурацию. Например, он заметил, что агент долго искал порт для тестов, и предложил исправить инструкцию в скилле, а также переписал шаблон changelog, чтобы не тратить время на правки. В живом демо на экране показали панель с графиками оценок и список PR, которые агент предложил для улучшения фабрики.
Практика
- Что получишь
- Сможете настроить цикл оценки и самосовершенствования агентов: собирать трассы, задавать рубрики и получать предложения по исправлению скиллов.
- Первый шаг
- Запустить бесплатный скилл Skill Doctor с warp.dev/skilldoctor на своих локальных беседах Claude или Codex и посмотреть отчёт.
- Цифры
- —100% — на команде Warp все подняли руки, что агенты пишут слишком много тестов
- —40% — доля зрителей в зале с той же проблемой по поднятию рук
- —200 — столько разговоров за 24 часа может просматривать агент для поиска провалов
- —0,4 — порог в рубрике, ниже которого оценка считается провалом
- Честно
- Автор — представитель Warp и продвигает Warp Factories и Skill Doctor, ссылки даёт в конце. Часть показанных экранов (дашборд с графиками и PR-инбокс) осталась только на слайдах, а живая демонстрация панели не удалась из-за потери доступа. Шаблоны рубрик в Skill Doctor общие; конкретные пороги и конфигурацию под свою команду придётся настраивать самостоятельно.
Если слова незнакомы — 4 терминов
- скиллинструкция или модуль, который задаёт агенту порядок работы
- агент-судьяLLM, который оценивает качество беседы агента по заданным критериям
- Docker-песочницаизолированное окружение, где агент работает над задачей, не влияя на основную систему
- pass/failоценка «прошёл/не прошёл» по порогу рубрики
Компоненты
7 шт.Формат: разбор · для продвинутых · уверенность разметки 0.8 · источник