Eagle 4: 3,6x ускорение Qwen 3 27B, но не для всех
Что в ролике
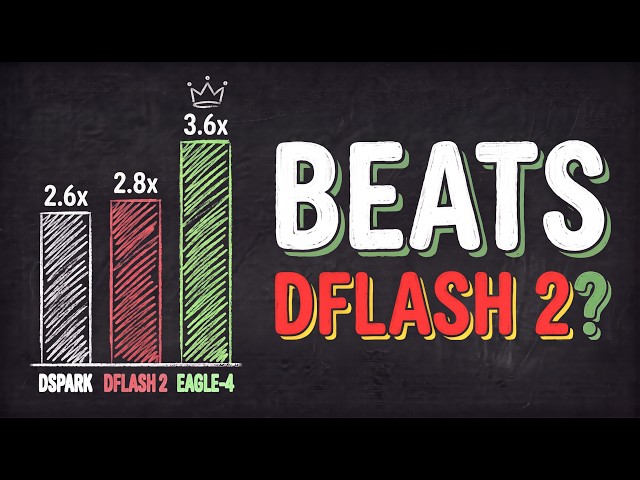
Если вы запускаете Qwen 3 27B на одной видеокарте, то знаете, как медленно модель набирает текст, и именно эту проблему решает вышедший 20 октября Eagle 4. Авторы заявляют ускорение в 3,59 раза по сравнению с обычной генерацией, но эта цифра получена на четырёх Nvidia B300 с одним пользователем и нулевой температурой, что далеко от типичной чат-нагрузки. При температуре 1 Eagle 4 даёт 2,59x, а конкурент DeepFlash 2 — 2,39x, то есть разрыв сокращается до примерно 8%, а при 512 одновременных пользователях Eagle 4 остаётся впереди с 1,34x, тогда как DeepFlash 2 и DeepSpark становятся медленнее, чем без ускорения. Секрет Eagle 4 в том, что он использует однослойный драфтер вместо пятислойных у конкурентов и сначала отбирает короткий список из 128 вероятных токенов, который содержит правильный ответ в 98% случаев, что снижает вычисления. На бумаге заявлены и другие цифры: на AMD MI355X — 3,49x, на Nemotron 3.5 Super (120B A12B) — 2,74x против 2,41x у встроенного MTP, а на телефоне Motorola Razr 70 Ultra с 4-битной Gemma 4 на CPU скорость выросла с 23 до 83 токенов в секунду. Однако пока Eagle 4 нельзя запустить дома: доступен только плагин для патченных версий SGLang, vLLM и TokenSpeed, протестированных на B300 и MI355X, а для llama.cpp и LM Studio поддержки нет, и даже тестовый drafter для Qwen 27B весит 6,2 ГБ и не выпущен для телефона. Автор советует не ждать Eagle 4, а включить встроенный MTP в Qwen 3 27B (ускорение 2,2x), затем попробовать DeepFlash 2 или DeepSpark в LM Studio, которые дают около 2,7-2,8x на одном пользователе.
Практика
- Что получишь
- Понимание, почему заявленное ускорение Eagle 4 в 3,6 раза — это лучший случай, а не типичный, и какие реально доступные методы ускорения Qwen 3 27B стоит использовать на своём железе.
- Первый шаг
- Включите встроенный MTP для Qwen 3 27B в llama.cpp или LM Studio — это бесплатно и уже поддерживается.
- Цифры
- —3,59x — ускорение Eagle 4 при температуре 0, одном пользователе и на четырёх Nvidia B300
- —1,34x — ускорение Eagle 4 при 512 одновременных пользователях, тогда как DeepFlash 2 даёт 0,78x, а DeepSpark — 0,67x от базовой скорости
- —83 токена/с — скорость генерации на телефоне Motorola Razr 70 Ultra с 4-битной Gemma 4 и Eagle 4, против 23 токенов/с без ускорения
- —6,2 ГБ — размер drafter Eagle 4 для Qwen 27B, что составляет заметную часть памяти даже до загрузки основной модели
- Честно
- Автор в конце ролика рекламирует членство на канале для приоритетных ответов в комментариях. Все цифры Eagle 4 взяты из статьи самой команды Eagle AI, независимого воспроизведения нет, а публичный релиз даёт лишь 3,3-3,4x на SGLang и около 3x на vLLM. Демонстрация на телефоне (83 токена/с) использует модифицированный llama.cpp и drafter, которые ещё не опубликованы, а для запуска на своей машине потребуются патченные движки и совместимые GPU (B300/MI355X).
Если слова незнакомы — 6 терминов
- спекулятивное декодированиеметод ускорения, при котором маленькая модель (драфтер) предлагает варианты следующих токенов, а большая модель проверяет их целиком, не теряя качества
- драфтермаленькая модель, которая быстро угадывает следующие токены, чтобы большая модель проверяла их пачкой
- MTPвстроенный в модель механизм предсказания нескольких следующих токенов за один шаг, ускоряющий генерацию
- температурапараметр генерации, управляющий случайностью: 0 — всегда выбирается самый вероятный токен, 1 — более разнообразный выбор
- токенединица текста, на которые модель разбивает ввод и вывод, обычно часть слова или символ
- квантизациясжатие весов модели до меньшей точности (например, 4-бит) для экономии памяти и ускорения, иногда с незначительной потерей качества
Связки из этого ролика
7 шт.- Qwen 3.8 27B + Eagle 4
- Qwen 3.8 27B + DFlash 2
- Qwen 3.8 27B + DeepSpark
- Gemma 4 4-bit + Eagle 4 on llama.cpp
- 4x Nvidia B300
- AMD MI355X
- Motorola Razr 70 Ultra
Компоненты
14 шт.Формат: разбор · для практикующих · уверенность разметки 0.95 · источник