Claude Code и Codex против людей в AI-спидраннах
Что в ролике
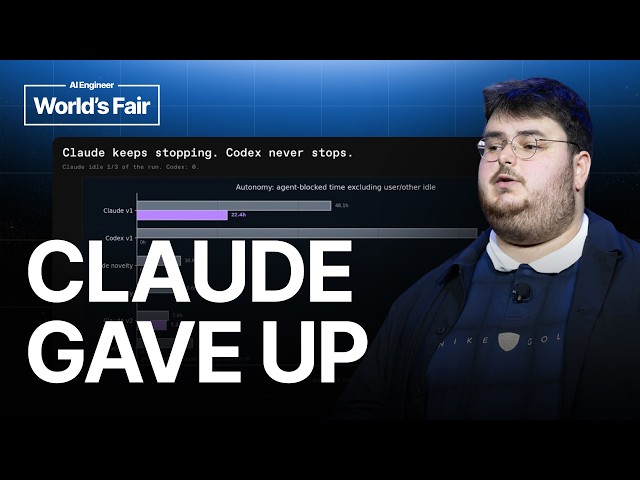
Чтобы проверить, могут ли модели сами вести AI-исследования, Prime Intellect запустила Claude Code и Codex в гонку с людьми на спидраннах обучения GPT-2: нужно достичь целевого значения функции потерь за минимальное время, а в оптимизатор-спидранне менять только параметры оптимизатора. Среду выбрали за скорость (прошлый рекорд около 2 минут, один запуск 15–20 минут) и чёткие правила, а агенты получили доступ к кластеру и могли читать логи, предлагать идеи и смотреть чужие рекорды. Claude Code каждые 9–10 часов останавливался со словами, что улучшить рекорд невозможно, и простаивал треть времени, тогда как Codex работал без перерывов, писал больше в свою память, порождал больше подагентов и тратил больше токенов, в том числе из-за окна контекста 250 тысяч токенов. На момент эксперимента лучший человеческий рекорд составлял 2 990 шагов, и агенты улучшили его: Claude Code примерно на 50–60 шагов, Codex — примерно на 20. В шестидневном заезде только с оптимизаторами Claude Code и Codex снова оказались сильны, а модель Kimi на четвёртый день сделала рывок и обошла Codex, при этом расходуя заметно меньше токенов. Codex активно искал статьи и нашёл одну, которую не находили другие модели, и именно она привела к рекорду. Главный вывод автора: ни один агент не придумал нового оптимизатора или механизма — все лишь комбинировали известные методы, поэтому как оценка среда работает, а как источник открытий пока нет.
Практика
- Что получишь
- Понимание, как устроены публичные бенчмарки для AI-исследований и что сейчас умеют агенты: улучшать чужие рекорды, но не изобретать новые методы.
- Первый шаг
- Начать с репозитория modded-nanoGPT — базового спидранна обучения GPT-2 — и попробовать воспроизвести его на своей машине.
- Цифры
- —2 990 шагов — человеческий рекорд до агентов
- —50–60 шагов — на столько Claude Code улучшил рекорд
- —9–10 часов — интервал, после которого Claude Code останавливался
- —треть времени — доля простоя Claude Code
- Честно
- Автор — сотрудник Prime Intellect, компания развивает инфраструктуру для агентов и упоминает в конце свой продукт для тренировки верификаторов, но прямых партнёрских ссылок нет. Повторить эксперимент нельзя: код агентов и точные конфигурации не опубликованы, а часть результатов видна только на слайдах, которые в транскрипт не попали.
Если слова незнакомы — 5 терминов
- функция потерьчисло, показывающее ошибку модели после обучения; чем ниже, тем ближе к целевой точности
- оптимизаторалгоритм, который обновляет параметры модели во время обучения для уменьшения ошибки
- токенминимальная единица текста, которую модель обрабатывает
- окно контекстаобъём текста, который модель может удерживать в одном запросе
- подагентвспомогательный агент, которого порождает основной агент для выполнения подзадачи
Связки из этого ролика
2 шт.- GPT-5.5 + XI
- Opus 4.8 + XI
Компоненты
8 шт.Формат: разбор кейса · для продвинутых · уверенность разметки 0.85 · источник