Мини-ПК с 192 ГБ против DGX Spark: тест под LLM
Что в ролике
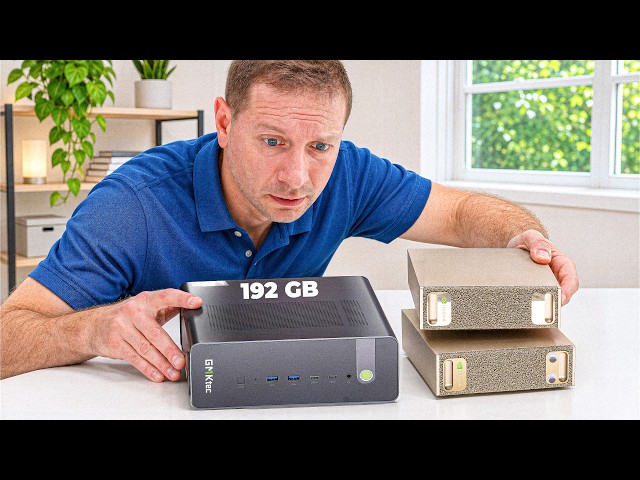
Если вам не хватает 128 ГБ памяти одного DGX Spark под модели класса 150 ГБ, автор сравнивает его с мини-ПК GMK Tech Evo X5 Pro на чипе AMD Ryzen AI Max Plus Pro 495, у которого 192 ГБ unified-памяти и цена 7000 долларов за версию с 4 ТБ. Из коробки на Windows 11 GPU получает только 128 ГБ, поэтому модель GLM 5.3 на 157 ГБ не помещается, но в BIOS можно поднять долю GPU до 160 ГБ, и тогда GLM 5.3 выдаёт 14,2 токена в секунду, DeepSeek V4 Flash — 15,9, а Qwen 3 235B — 15,8. На генерации токенов машины почти равны из-за одинаковой пропускной способности памяти, но на обработке длинных промптов DGX Spark опережает в 1,5–3 раза: 10 000 токенов кода в dense-модели Qwen 3.8 27B читаются на GMK около 30 секунд против 12 секунд на Spark. При этом 192 ГБ дают GMK решающее преимущество в контексте: модель Qwen 3.8 Flash Next на 120 ГБ держит все 262 000 токенов контекста, тогда как Spark упирается в 61 000, а на одинаковой длине 58 000 токенов GMK выдаёт 25 токенов в секунду против 17,3 у Spark. Для агентов автор загрузил четыре модели одновременно: GMK держит их все в памяти, а Spark вынужден подгружать четвёртую и теряет 79 секунд на каждой итерации, поэтому GMK делает 0,63 задачи в минуту против 0,54 у Spark. Однако живой Docker-инструмент для агентов съедает системную память, и при выделении 160 ГБ GPU остаётся только 32 ГБ — этого хватает лишь на двух чистых агентов против восьми у Spark, который делит память динамически. В WSL2 с Ubuntu GPU не виден, поэтому для Linux нужна двойная загрузка, а после одного исправления в ComfyUI скорость генерации видео на LTX 2.3 выросла почти в пять раз и Linux стал быстрее Windows, хотя Spark всё равно рендерит 5-секундный клип за 41 секунду против 126.
Практика
- Что получишь
- Поймёте, чем 192 ГБ unified-памяти мини-ПК отличаются от 128 ГБ DGX Spark: какие модели поместятся, где Spark быстрее, сколько агентов можно запустить и как настроить BIOS и Linux.
- Первый шаг
- Если хотите повторить на GMK, сначала загрузите Llama CPP с бэкендом Vulkan и поднимите UMA frame buffer до 160 ГБ в BIOS.
- Цифры
- —7000 долларов — цена GMK Tech Evo X5 Pro с 4 ТБ, что примерно на 150 долларов дороже одного DGX Spark при 64 ГБ дополнительной памяти
- —14,2 токена в секунду — генерация GLM 5.3 на GMK после выделения 160 ГБ GPU
- —262 000 токенов — полный контекст Qwen 3.8 Flash Next на GMK против 61 000 у Spark
- —41 секунда — время генерации 5-секундного клипа LTX 2.3 на Spark против 126 секунд на GMK с Linux-фиксом
- Честно
- Ролик содержит рекламную вставку Merlin AI: автор даёт промокод на годовую подписку за 60 долларов и партнёрскую ссылку в описании. Все тесты сделаны на конкретных сборках Llama CPP, движках Vulkan, Rocm и Halogen, поэтому цифры могут измениться после обновлений; часть результатов, например Halogen, получена на закрытом движке с собственными весами, который не подходит для обычной модели. Для повторения с GLM 5.3 придётся зайти в BIOS и на Windows вручную настроить файл подкачки — в пересказе этих шагов нет.
Если слова незнакомы — 5 терминов
- unified-памятьобщая память для CPU и GPU без отдельной видеопамяти
- токенединица текста, которую модель читает или генерирует
- промпттекст-задание, которое вы подаёте модели
- MoEархитектура, где на каждый токен работает только часть параметров
- UMA frame bufferнастройка BIOS, сколько общей памяти отдать GPU
Понадобится экран
Часть информации есть только на экране (настройки). Открыть на YouTube с 13:39.
Связки из этого ролика
7 шт.- llama.cpp + Vulkan
- llama.cpp + ROCm
- ComfyUI + ROCm
- vLLM + GMK Tech
- Halogen + AMD
- DS4 + DeepSeek
- WSL + Ubuntu
Компоненты
15 шт.Цитаты-доказательства
дословно из субтитровФормат: обзор · для продвинутых · уверенность разметки 0.9 · источник