Первый AI eval: критерии и судья в Arize
Что в ролике
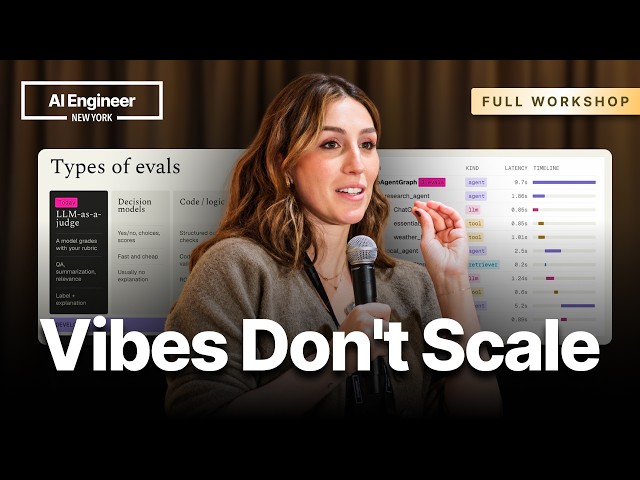
Спикер объясняет, почему «вайб-чеки» не масштабируются: без eval нельзя детектировать регрессии, сравнивать промпты и модели, и ставить качественные гейты в CI. Она вводит понятия трасс и спанов: трасса — это логи всех шагов агента, а eval — это тесты, и без наблюдаемости их не построить. Среди типов eval она выделяет LLM-as-a-judge, decision models, код-тесты, аннотации, agent-as-a-judge, пользовательскую обратную связь и бизнес-метрики, но фокус воркшопа — LLM-as-a-judge, где вторая модель ставит лейбл и объяснение. Участникам предлагается демо-проект travel agent в Arize AX: они изучают трассы с запросами вроде поездки в Прагу на три дня с бюджетом 800 долларов и определяют конкретные критерии успеха вместо общих слов. Затем нужно описать задачу, успех, провал и по три пункта для pass/fail, потому что эти формулировки превращаются в промпт. В промпт-плейграунде Arize создаётся шаблон eval, подключаются переменные через variable mapping и загружается датасет из выбранных спанов. После прогона eval на модели она предлагает смотреть на лейблы и объяснения, чтобы итерировать шаблон, а затем сохранить его как evaluator для использования на своих данных.
Практика
- Что получишь
- Чёткое определение eval и критериев, умение превратить критерии в промпт для LLM-судьи и пошаговый план создания evaluator в Arize AX.
- Первый шаг
- Завести бесплатный аккаунт Arize AX, открыть демо-проект travel agent и выбрать несколько трасс, чтобы посмотреть, какие данные есть в спанах.
- Цифры
- —32 — столько eval сейчас автоматически прогоняется на агенте Alex в Arize, по словам спикера
- —20 — с такого количества трасс рекомендовано начинать: один критерий, один судья, потом расширять
- —800 долларов — бюджет поездки в примере демо-агента, на котором участники тренируются
- Честно
- Воркшоп продвигает платформу Arize: все действия выполняются в её интерфейсе, а инструкции и QR-код с one-pager видны только на экране и вряд ли доступны без записи. Для повторения нужен аккаунт Arize AX и API-ключ от Anthropic, OpenAI или другого LLM-провайдера. Часть шагов (фильтры, variable mapping, кнопки) показана только визуально, без текстовых инструкций в транскрипте.
Если слова незнакомы — 6 терминов
- evalавтоматическая проверка качества ответа агента по заданному критерию
- трассазапись всех шагов, которые агент сделал от запроса пользователя до ответа
- спанотдельный шаг внутри трассы, например вызов инструмента или обращение к модели
- LLM-as-a-judgeметод оценки, при котором вторая языковая модель выставляет лейбл и объяснение ответу агента
- variable mappingпривязка переменных в шаблоне eval к конкретным полям данных из трасс или датасета
- CIнепрерывная интеграция, автоматический запуск проверок при изменениях кода
Связки из этого ролика
1 шт.- LangGraph
Компоненты
5 шт.Формат: пошаговый урок · для практикующих · уверенность разметки 0.9 · источник