Техническая проверка ИИ-автоматизации: три вопроса
Что в ролике
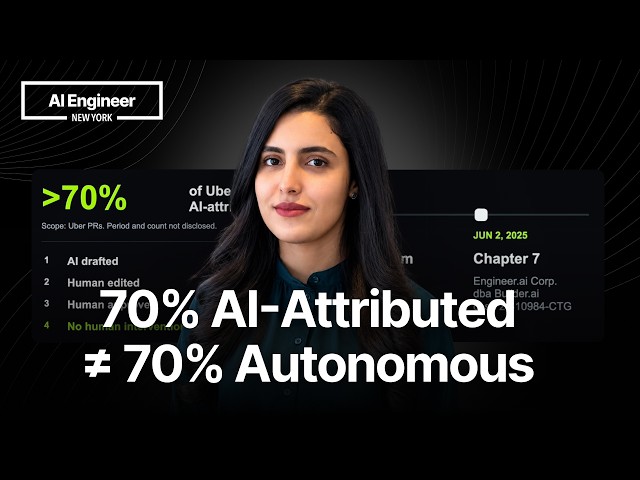
Когда вам показывают цифру вроде «70% автоматизировано» или «на 55,8% быстрее», техническая проверка должна выяснить, что должно быть правдой, чтобы эта цифра имела значение, — и автор предлагает три проверки. Первая проверка — арифметика: сравнить объём рабочей нагрузки с полной стоимостью труда, потому что данные Faros по 10 000+ разработчиков из 1 255 команд показывают, что команды с высоким уровнем использования ИИ сливали на 98% больше pull request'ов, время ревью выросло на 91%, а средний pull request стал на 154% больше, то есть в систему попало больше работы и выросла нагрузка на проверяющих, а не произошло автоматическое сокращение штата. Вторая проверка — определение: заявление Uber о 70% ИИ-атрибутированных pull request'ов не равно показателю полной автономности, период и общее число не раскрыты, поэтому автор предлагает размещать каждое заявление на лестнице от «ИИ набросал» до «вмешательства человека не было» и использовать термин straight-through processing для сквозной обработки без участия человека внутри названной границы. Третья проверка — оценка: Meta обнаружила разрыв в 24 процентных пункта между автоматическим грейдером и решением о принятии кода после корректировки на человеческий базовый уровень, когда четверо мейнтейнеров из трёх репозиториев проверили 296 ИИ-сгенерированных pull request'ов, не зная их происхождения, и автоматический оценщик оказался существенно оптимистичнее людей, отвечающих за принятие работы. В собственном проекте автора все 10 из 10 выходов проходили автоматическую валидацию, но после привлечения экспертов выживали единицы, поэтому при проверке стоит спрашивать, кто размечал ground truth, согласны ли эксперты и какие плохие выходы ускользнули. Даже если заявление пережило эти проверки, оно должно пройти экономику: начать с ценности подходящего рабочего процесса, применить реальное внедрение, успех straight-through processing и принятое качество, затем вычесть стоимость ИИ, человеческого ревью, эскалаций и переделок, чтобы получить стоимость принятой автономной задачи. Доклад заканчивается предостережением Builder.ai: предупреждения существовали с 2019 года, но оценку выручки за 2024 год пересмотрели с $220 млн до примерно $55 млн, а в июне 2025 компания подала заявление по главе 7, что показывает: предупреждение без превращения в шлагбаум — это не проверка, и итог — «верь, если проверено, или уходи».
Практика
- Что получишь
- Три проверяемых вопроса для оценки заявлений об автоматизации: сравнение рабочей нагрузки с полной стоимостью труда, определение границ автономности и проверка качества оценки.
- Первый шаг
- Скачать карточку с тремя проверками по QR-коду из выступления или выписать их самостоятельно и взять на следующую встречу с вендором или обсуждение инвестиций.
- Цифры
- —98% — на столько больше pull request'ов сливали команды с высоким уровнем использования ИИ в наблюдательных данных Faros.
- —24 процентных пункта — разрыв между автоматическим оценщиком и решением о принятии кода в эксперименте Meta.
- —296 — столько ИИ-сгенерированных pull request'ов проверили четверо мейнтейнеров из трёх репозиториев, не зная их происхождение.
- —$220 млн → $55 млн — пересмотр оценки выручки Builder.ai за 2024 год перед подачей заявления о банкротстве по главе 7 в июне 2025.
- Честно
- Ролик не продвигает платный продукт, но предлагает бесплатную карточку и исходные заметки на своём сайте. Часть данных (например, детали эксперимента Meta и внутренние метрики) показана на экране или упомянута без полного контекста, поэтому для повторения расчётов может не хватать исходных данных. В докладе нет пошаговых инструкций — только методология проверки.
Если слова незнакомы — 5 терминов
- technical due diligenceтехническая проверка компании перед сделкой или инвестицией
- straight-through processingсквозная обработка без участия человека в заданных границах
- ground truthэталонные правильные ответы, с которыми сравнивают работу модели
- pull requestзапрос на включение изменений в основную ветку кода
- автоматический грейдерпрограмма, которая оценивает качество ответов по заранее заданным правилам
Формат: разбор · для бизнеса · уверенность разметки 0.9 · источник