RAG с нуля на Python: локально за 50 строк
Что в ролике
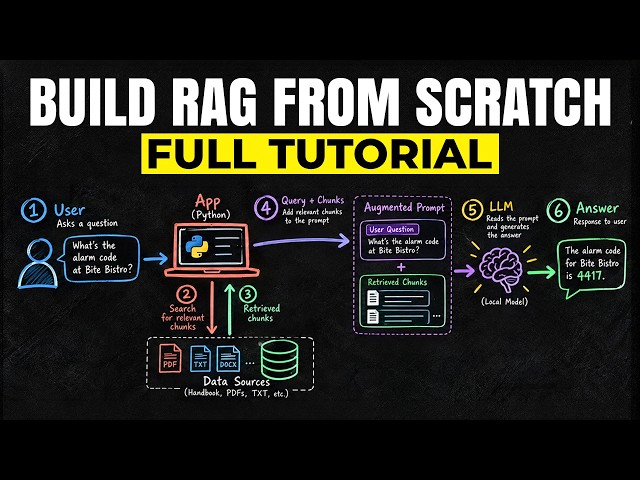
Чтобы ответить на вопрос по внутреннему документу, модели нужно подсунуть нужный фрагмент, а не весь файл — именно это делает RAG, и автор показывает его устройство на простом примере. В ролике используется локальный стек: установленный через Ollama эмбеддинг-модель nomic-embed-text превращает текст в вектор из 768 чисел, а чат-модель Qwen 3 4B instruct генерирует ответ, всё бесплатно и без внешних API. Документ — employee handbook вымышленной кофейни Bite Bistro — делится на 11 кусков по абзацам. Каждый кусок векторизуется, затем вопрос тоже превращается в вектор и сравнивается с кусками через косинусное сходство. Три самых похожих куска добавляются в промпт с инструкцией отвечать только по контексту, и модель выдаёт ответ, например «собаки только на патио» или «кафе открывается в 7:00». Вся программа занимает менее 50 строк Python и использует только requests и NumPy. В конце автор отмечает, что в проде добавляют векторную базу, переранжирование и оценку качества, но базовая схема остаётся той же.
Практика
- Что получишь
- Поймёте, как RAG устроен изнутри, и сможете собрать локальную систему вопросов-ответов по своим документам без LangChain и внешних API.
- Первый шаг
- Установите Ollama и скачайте модели nomic-embed-text и qwen3:4b-instruct, затем создайте Python-скрипт с функциями запросов к локальному API.
- Цифры
- —274 МБ — размер эмбеддинг-модели nomic-embed-text, которая работает локально
- —2,5 ГБ — размер чат-модели Qwen 3 4B instruct, подходящей для обычного ноутбука
- —11 — столько кусков получилось после разбиения handbook по абзацам
- —50 — столько строк кода нужно для всей системы
- Честно
- В середине ролика автор рекламирует курсы Triple Ten и призывает подписаться на своё бесплатное сообщество, где обещает выложить код. Точные команды установки, полный код и файл handbook.md показаны на экране, но в пересказе их нет — для повторения придётся смотреть видео или брать код из описания.
Если слова незнакомы — 5 терминов
- RAGпоиск релевантных кусков документа и передача их в промпт, чтобы модель отвечала по ним
- эмбеддингпреобразование текста в список чисел, отражающих смысл
- векторнабор чисел, представляющий текст или вопрос для сравнения
- косинусное сходствомера того, насколько два вектора указывают в одном направлении; 1 — похожи, 0 — не связаны
- промпттекст-задание, который отправляется модели
Понадобится экран
Часть информации есть только на экране (код в терминале). Открыть на YouTube с 7:20.
Связки из этого ролика
1 шт.- Python + Ollama + NumPy
Компоненты
8 шт.Цитаты-доказательства
дословно из субтитровФормат: пошаговый урок · для практикующих · уверенность разметки 0.9 · источник