Модель Whistle на ESP32: офлайн-распознавание речи
Что в ролике
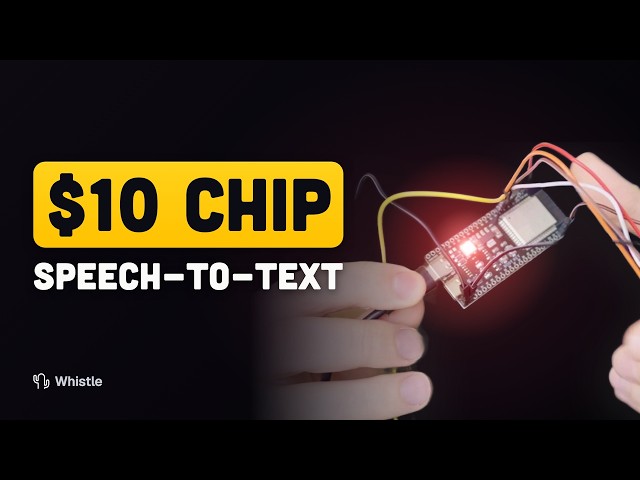
Чтобы встроить голосовые команды в крошечное железо, автор показывает модель Whistle от Cactus Compute: это один файл на 16,9 МБ, понимающий семь языков, и он почти в девять раз меньше Whisper Base при лучших результатах на LibriSpeech. Автор берёт плату ESP32-S3 с 16 МБ флеша, куда полная модель не влезает, и обрезает декодер с восьми до четырёх слоёв по «лестнице интеллекта», оставляя 98 КБ свободного места; энкодер при этом не урезается. Он собирает офлайн-устройство с микрофоном INMP441 и кнопкой, а вместо Needle пишет парсер, который достаёт из транскрипта цвет и команду для RGB-светодиода. После оптимизации матричных вычислений под 8-битные целые числа и оба ядра чипа команда «flash the light blue» обрабатывается за 8,8 секунды, французская фраза — за 11,7, а средний отклик четырёхслойной версии около 10 секунд. На синтетических тестах английские цветовые команды распознаются верно в 78% случаев, а короткие фразы вроде «make it red» дают 82–93% точности, тогда как одиночное слово «red» — только 44%. Обрезанная версия на чипе обгоняет полную модель Cactus на цветовых командах за счёт подсказок списка цветов и повторной попытки на другом языке. Модель выпущена под лицензией Apache 2.0 и лежит на HuggingFace.
Практика
- Что получишь
- Вы получите готовую схему и подход: как обрезать Whistle до четырёх слоёв декодера, собрать ESP32-S3 с микрофоном INMP441 и добиться ответа за 8–11 секунд. Плюс узнаете, почему короткие фразы распознаются лучше одиночных слов и как улучшить точность цветовых команд.
- Первый шаг
- Скачайте репозиторий по ссылке в описании, загрузите прошивку на ESP32-S3 и соберите плату с микрофоном INMP441 и кнопкой, следуя схеме.
- Цифры
- —16,9 МБ — размер файла модели Whistle, почти в 9 раз меньше Whisper Base
- —8,8 секунды — столько заняла обработка команды «flash the light blue» на ESP32-S3
- —78% — точность английских цветовых команд на синтетических тестах
- —44% — точность распознавания одиночного слова «red»; короткие фразы дают 82–93%
- Честно
- Рекламы сторонних продуктов нет, но в конце автор просит лайк и подписку на канал Better Stack; исходники лежат в открытом GitHub-репозитории по ссылке в описании. Цифры точности получены на синтетических тестовых голосах, поэтому на живой речи результат может отличаться. Для повторения нужен паяльник, плата ESP32-S3, микрофон INMP441 и сборка прошивки — подробная инструкция есть только в репозитории, а в ролике показаны ключевые шаги.
Если слова незнакомы — 3 терминов
- энкодерчасть модели, которая преобразует звук в представление для декодера
- декодерчасть модели, которая по этому представлению пошагово пишет текст
- лестница интеллектаспособ обрезать декодер до нужного числа слоёв и получить работающую уменьшенную модель
Связки из этого ролика
1 шт.- ESP32-S3 + INMP441 + Whistle
Компоненты
3 шт.Формат: сборка на живом примере · для продвинутых · уверенность разметки 0.8 · источник