Mac M5 Ultra против двух DGX Spark: чтение и генерация
Что в ролике
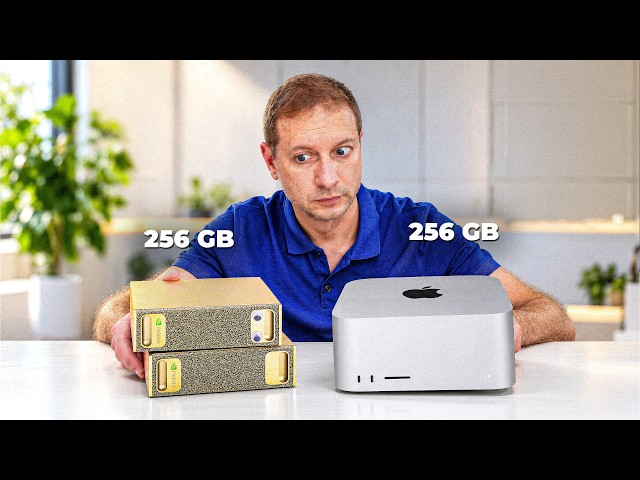
Автор ставит рядом Mac Studio M5 Ultra с 256 ГБ памяти и две NVIDIA DGX Spark по 128 ГБ, которые работают через vLLM с Tensor Parallel и соединены RDMA-кабелем. На коротких ответах обе машины выдают около 38 токенов в секунду, но при чтении длинных промптов Sparks обгоняют Mac в два-три раза. На 32 000 токенах кодовой базы два Spark начали генерировать ответ через 17 секунд, тогда как Mac ждал 50 секунд, хотя при 2000 токенах разница была несущественной. Скорость генерации зависит от движка: на Mac DeepSeek V4 Flash выдаёт 53 токена в секунду через MLX против 40 через llama.cpp, а вторая тестовая модель на Mac также пишет быстрее пары Spark. Для нескольких пользователей картина меняется: на восьми одновременных сессиях Sparks выдают около 25, а Mac — 11 токенов в секунду суммарно, и каждый пользователь на Mac ждёт первую букву больше минуты. По железу Mac тянет 434 Вт, связка Sparks — 410 Вт, обе греются до 49–63 °C, а настройка Sparks требует совпадения ОС, ядра, драйверов и переменных vLLM/RDMA. Итог: Mac удобнее для одного-двух человек и обычной работы, Sparks лучше для команды и длинных запросов, но кэш сессии смягчает задержку повторных вопросов.
Практика
- Что получишь
- Понимание, чем отличаются Mac Studio M5 Ultra и пара DGX Spark на реальных моделях: как они читают длинные промпты, генерируют текст и ведут себя при нескольких пользователях.
- Первый шаг
- Начните с официальных рецептов build.nvidia.com/spark для связки из двух Spark или установите llama.cpp/MLX на Mac и прогоните свой типичный сценарий на промпте в 32 000 токенов.
- Цифры
- —17 секунд против 50 секунд — задержка первого токена на промпте из 32 000 токенов кодовой базы: пара DGX Spark против Mac Studio M5 Ultra
- —53 против 40 токенов в секунду — скорость генерации DeepSeek V4 Flash на Mac через MLX и llama.cpp
- —434 Вт и 410 Вт — энергопотребление под нагрузкой Mac Studio M5 Ultra и пары DGX Spark
- —14 000 долларов — цена Mac в тестовой конфигурации с 8 ТБ SSD, тогда как пара Sparks с кабелем обходится примерно в 10 000 долларов
- Честно
- Ролик содержит рекламную интеграцию Merlin AI с промокодом автора и партнёрской ссылкой в описании, а отдельное видео с техниками ускорения, включая prefix caching, доступно только участникам платного сообщества канала. Часть замеров сделана в упрощённых условиях: MLX-бенчмарк для DeepSeek гонялся напрямую через движок, а не через HTTP-сервер, и влияние RDMA-кабеля на скорость отдельно не проверялось.
Если слова незнакомы — 6 терминов
- vLLMдвижок для запуска больших языковых моделей, который распределяет модель по нескольким устройствам
- Tensor Parallelспособ разрезать слои модели между GPU, чтобы каждый считал свою часть и обменивался результатами
- RDMAпрямой доступ к памяти другого компьютера без участия его процессора
- MLXбиблиотека Apple для запуска нейросетей на чипах M
- llama.cppпопулярный движок для локального запуска моделей на разных процессорах
- токенединица текста, примерно три четверти слова, в которых модели читают и пишут
Связки из этого ролика
5 шт.- vLLM tensor parallel on dual DGX Spark
- llama.cpp on Mac
- MLX on Mac
- O-MLX on Mac
- CUDA + vLLM
Компоненты
9 шт.Формат: обзор · для продвинутых · уверенность разметки 0.8 · источник