Как устроены инференс-движки: llama.cpp и vLLM
Что в ролике
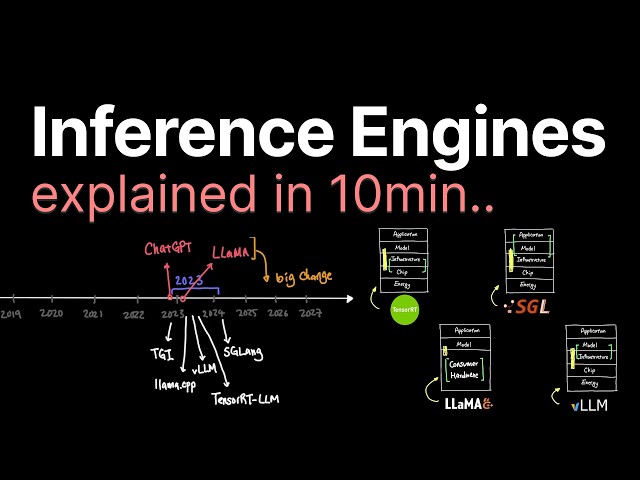
При выборе движка для запуска LLM легко запутаться: llama.cpp, vLLM, SGLang и TensorRT-LLM вышли в 2023–2024 годах и оптимизируют разные места одного и того же процесса. PyTorch изначально был общим инструментом для тензорных моделей и не был заточен под авторегрессионные LLM, поэтому llama.cpp специализировался на инференсе и снижении памяти, а благодаря квантованию и memory mapping смог запускать модель Llama 7B на смартфонах. vLLM пошёл в другую сторону: он принял железо как есть и нацелился на пропускную способность через PagedAttention, который хранит растущий KV-кэш в блоках фиксированного размера вместо непрерывных областей, и через continuous batching, позволяющий дожимать очередь запросов. SGLang добавил radix attention: если несколько пользователей начинают промпт с одинаковой фразы вроде «You are a helpful assistant», движок переиспользует общий префикс KV-кэша в древовидной структуре и не пересчитывает его заново, за счёт чего на некоторых задачах пропускная способность вырастала до 6,4 раза. NVIDIA, владея уровнем чипов, выпустила TensorRT-LLM, чтобы выжать максимум из собственного железа и снизить совокупную стоимость владения, а не просто продавать GPU. Сейчас движки сошлись к похожему набору функций, но давление меняется: агентные приложения требуют долгих сессий, а архитектуры DeepSeek, Kimi, Meta и MiniMax имеют свои особенности ядер, поэтому понимание узких мест важнее запоминания названий.
Практика
- Что получишь
- Понимание, чем отличаются основные инференс-движки и какую задачу каждый решает, чтобы осознанно выбирать инструмент под свои ограничения по памяти, железу и числу пользователей.
- Первый шаг
- Начать с llama.cpp на своём компьютере и запустить небольшую квантованную модель, чтобы увидеть memory mapping и квантование на практике.
- Цифры
- —60–80% памяти терялось в старых методах управления KV-кэшем из-за фрагментации и резервирования, по оценке статьи vLLM
- —6,4 раза — на столько SGLang ускорял инференс на задачах с общими префиксами в промптах
- —7B — модель Llama такого размера удалось запустить на смартфонах благодаря llama.cpp
- Честно
- Ролик спонсирован Zapier, и часть про интеграции — реклама с партнёрской ссылкой; в остальном это образовательный разбор без продажи курса. Повторить оптимизации по видео не получится: все примеры показаны на схемах и объяснениях, исходного кода или пошаговых команд нет.
Если слова незнакомы — 7 терминов
- LLMбольшая языковая модель, которая предсказывает следующий токен
- квантованиесжатие весов модели для уменьшения занимаемой памяти
- memory mappingотображение файла модели в виртуальную память, чтобы ОС подгружала только нужные страницы
- KV-кэшкэш ключей и значений внимания, чтобы не пересчитывать уже обработанные токены
- PagedAttentionхранение KV-кэша в блоках фиксированного размера вместо непрерывной области
- continuous batchingпоточная пакетная обработка, при которой новые запросы добавляются по мере завершения старых
- radix attentionпереиспользование общих префиксов KV-кэша через древовидную структуру
Компоненты
9 шт.Формат: разбор · для практикующих · уверенность разметки 0.85 · источник