Tone-Bench: бенчмарк против ИИ-слопа
Что в ролике
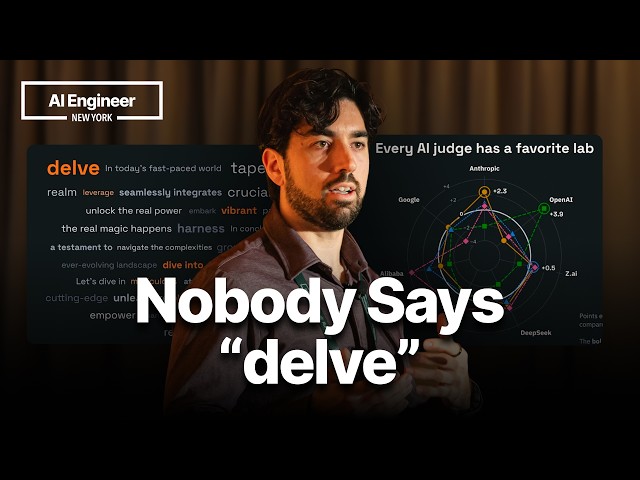
Если вас раздражают слова-паразиты вроде delve, общие фразы и безликий тон в сгенерированных текстах, этот доклад предлагает не очередную жалобу, а способ измерить проблему. Автор выделяет шесть признаков слопа: переиспользованные слова, обобщённость, пустые фразы, повторы, галлюцинации и неправильный или отсутствующий тон. Для измерения он представил Tone-Bench: 10 реальных задач по написанию видеосценариев, в которых модель получает развёрнутый бриф и исследование, а затем генерирует пять черновиков. Каждый черновик оценивают четыре LLM-судьи по девяти метрикам, сгруппированным в тон, качество письма, следование инструкциям, точность исследования и уровень слопа. Промпт для судьи содержит около 14 000 слов и требует сначала выбрать категорию, а потом поставить оценку, чтобы снизить нестабильность качественных суждений. По предварительным выводам GLM 5,3 flash оказывается в 50 раз дешевле лучшего Opus 5,5 extra high при схожих результатах, а практичнее искать модель, которая меньше всего раздражает при правках. Для повторения автор советует максимально длинный промпт с примерами, одну-три итерации с высокоинтеллектуальным судьёй и генерацию десяти дешёвых черновиков с последующей сборкой лучших частей. Бенчмарк уже опубликован и открыт, но он субъективен: измеряет, насколько модель пишет в тоне самого автора.
Практика
- Что получишь
- Понимание, из чего складывается слоп и как устроен практичный бенчмарк для оценки творческого письма, а также готовые приёмы: длинный промпт, итерации с судьёй и сборка лучших черновиков.
- Первый шаг
- Собрать один подробный промпт с примерами своих текстов и прогнать через него несколько моделей, сверяясь с рубриками Tone-Bench.
- Цифры
- —500 часов — столько ушло у команды на подготовку 10 сценариев, рубрик и примеров для Tone-Bench
- —120 моделей — столько прогнали через бенчмарк, генерируя по 5 черновиков на 10 задач
- —14 000 слов — примерный объём инструкции, которую получает LLM-судья для оценки одного сценария
- —в 50 раз дешевле — настолько GLM 5,3 flash дешевле Opus 5,5 extra high при близких, по оценке автора, результатах
- Честно
- Это доклад от команды Towards AI, и автор прямо предлагает помощь с построением собственных eval-пайплайнов, так что это частично промо его компании. Бенчмарк субъективен: он оценивает, насколько модель пишет в личном тоне автора, а не универсально лучший текст; часть проверки построена на LLM-судьях, у которых есть сдвиг в пользу собственного семейства, и лишь 1 000 пар сравнивали вручную. Полные промпты и рубрики лежат на сайте бенчмарка, в самом выступлении показаны только фрагменты.
Если слова незнакомы — 5 терминов
- слопнизкокачественный сгенерированный текст, который ощущается как шаблонный и безликий
- LLM-судьяязыковая модель, которая оценивает текст по заданным критериям вместо человека
- промпттекст-инструкция, который отправляется модели
- бенчмаркнабор задач и метрик для сравнения моделей между собой
- галлюцинациякогда модель уверенно выдаёт факт или деталь, которых не было в исходных материалах
Компоненты
8 шт.Формат: разбор · для продвинутых · уверенность разметки 0.85 · источник