Инференс без простоев: батчинг, дизагрегация и KForge
Что в ролике
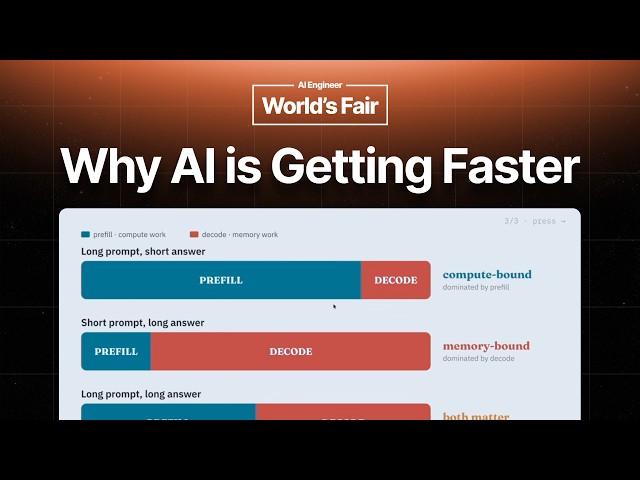
Доклад инженеров Cerebras и Gimlet Labs начинается с масштаба: затраты на ИИ-вычисления в этом году оцениваются в $765 млрд, к 2031 году — $1,6 трлн, а Google вырос с 480 триллионов до 3,2 квадриллиона токенов в месяц. При этом Llama 3.3 70B стала на 25% дешевле и в 3,6 раза быстрее, а генерация идёт авторегрессионно, из-за чего до 90% времени вычисления простаивают в ожидании памяти. Базовые оптимизации — continuous batching, paged KV cache, prompt caching и chunked prefill — сокращают простои, утилизируют память и не дают длинным prefill-запросам забивать очередь. Дальше идёт системная дизагрегация: prefill и decode разносят по отдельным пулам, а Cerebras с 21 000 терабайт в секунду и скоростью decode 3000 токенов в секунду против 600 у H100 позиционируется как decode-машина. Gimlet строит мультикремниевое облако, которое раскладывает нагрузку на подходящее железо и за счёт этого получает от 3 до 10 раз более быстрый инференс при том же бюджете мощности. Спекулятивное декодирование с черновой моделью снижает число запусков полной модели, а attention-FFN-дизагрегация разносит даже слои модели по разным машинам. В финале они показывают агента KForge, который за неделю ускорил GPT-OSS 12B на AMD на 33% end-to-end, и обещают замкнуть петлю: агенты проектируют чипы, компиляторы и даже бэк-офис.
Практика
- Что получишь
- Понимание основных техник ускорения инференса — от continuous batching и paged KV cache до спекулятивного декодирования и дизагрегации по фазам, а также аргументы, чем подход Cerebras отличается от мультикремниевого облака Gimlet.
- Первый шаг
- Начать с оценки собственной нагрузки: измерить длины входящих промптов и генерируемых ответов, чтобы понять, prefill-bound она или decode-bound.
- Цифры
- —$765 млрд — затраты на ИИ-вычисления в текущем году по оценке докладчиков, к 2031 году прогноз $1,6 трлн
- —3,2 квадриллиона токенов в месяц — рост Google с 480 триллионов годом ранее
- —21 000 терабайт в секунду — пропускная способность памяти Cerebras против 3,35 терабайт/с у H100
- —33% — ускорение GPT-OSS 12B на AMD, полученное агентом KForge меньше чем за неделю
- Честно
- Это промо-доклад обеих компаний: Cerebras рекламирует свой CS3 и партнёрство с AWS Trainium, Gimlet — свою NeoCloud и агента KForge. Воспроизводимого кода и настроек в выступлении нет, а цифры по скорости и ускорению даны как заявления вендоров, без независимых замеров.
Если слова незнакомы — 8 терминов
- авторегрессионная генерацияспособ выдачи текста, при котором каждый следующий токен вычисляется на основе всех предыдущих
- continuous batchingподстановка новых запросов в освободившиеся слоты одного прохода по весам модели
- KV-кэшпамять с векторами ключей и значений для обработанных токенов, которую модель перечитывает на каждом шаге
- paged KV cacheстраничная организация KV-кэша, которая выделяет память виртуально и не резервирует пустые блоки
- prefill и decodeдве фазы инференса: обработка всего входящего промпта и генерация токенов по одному
- chunked prefillразбиение длинной prefill-фазы на части, чтобы она не блокировала другие запросы
- дизагрегацияразделение инференс-нагрузки на отдельные пулы или машины по фазам и типам вычислений
- спекулятивное декодированиечерновая маленькая модель генерирует токены-кандидаты, а полная модель их быстро проверяет
Связки из этого ролика
3 шт.- Cerebras + AWS Trainium
- multi-silicon inference cloud
- speculative decoding draft/verify
Компоненты
7 шт.Формат: разбор · для практикующих · уверенность разметки 0.9 · источник