Как проверить, что быстрая модель быстрее на всей задаче
Что в ролике
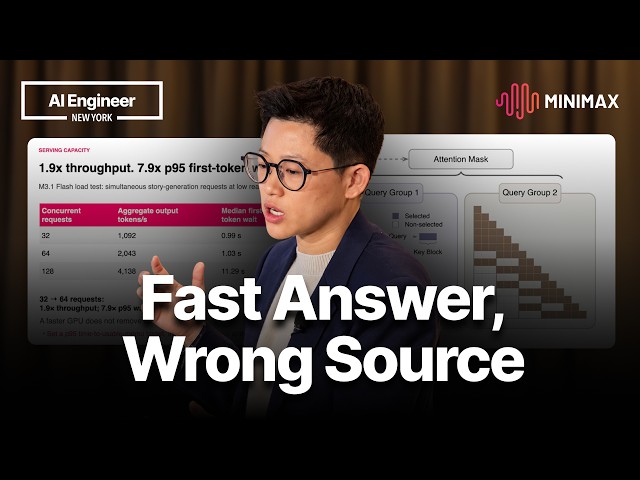
Если у вас уже есть приложение или рабочий процесс на языковой модели, появление M3.1 flash ставит вопрос не про токены в секунду, а про то, быстрее ли закрывается вся задача, например исследовательский отчёт о поставщиках печатных плат для AI-серверов. Автор разбирает внутренние изменения модели: разреженное внимание сначала отбирает блоки текста, а полный расчёт идёт только по ним; KV-кэш для ключей и значений сжимается с восьми до четырёх бит, а у экспертов MoE четырёхбитными становятся веса и активации. Эти оптимизации проверяются отдельными техническими тестами: на размещении фактов в длинном контексте модель проходит все 39 запросов, самый длинный вход — около 830 тысяч токенов, а средний балл почти не меняется, хотя один из показателей проседает на 6,6 процентного пункта. На сервинге speculative decoding даёт прирост общей пропускной способности примерно в 1,9 раза при росте одновременных запросов с 32 до 64, но время ожидания первого токена для 95% запросов растёт с 1,5 до 11,3 секунды, то есть в восемь раз. Управление бюджетом рассуждений тоже меняет результат: в одном кодинг-тесте режим high даёт меньше выходных токенов, чем max, но точность падает с 80% до 68%, поэтому бюджет нужно подбирать под задачу. Для исследовательской задачи автор предлагает зафиксировать источники и критерии готового отчёта, затем считать полную стоимость: поиск источников, вызовы инструментов, повторы и ручные исправления до состояния, когда аналитик может открыть первоисточник и пересчитать цифры. Только после этого можно сравнивать модели и решать, переходить ли на новую модель: важна не скорость генерации, а время и цена отчёта, пригодного для работы.
Практика
- Что получишь
- Понятный набор проверок для перехода на новую модель: как сравнивать полное время и стоимость готового результата, а не скорость генерации токенов.
- Первый шаг
- Сначала зафиксируйте один и тот же набор исходных отчётов, информационный срез и критерии готового результата, а затем прогоните текущую и новую модель на одной задаче.
- Цифры
- —830 тысяч токенов — самый длинный вход в тесте на поиск фактов в длинном контексте
- —6,6 процентного пункта — настолько просел один из показателей точности при 4-битном KV-кэше
- —1,9 раза — рост общей пропускной способности при росте одновременных запросов с 32 до 64, при этом P95 первого токена вырос с 1,5 до 11,3 секунды
- —80% против 68% — точность кодинг-теста при max и high бюджете рассуждений
- Честно
- Доклад рекламирует языковую модель M3.1 flash и видеомодель MiniMax A3, которую показывает в конце, но практических инструкций по настройке нет: названы только направления оптимизаций и принципы тестирования. Все цифры — из внутренних тестов MiniMax, методика и данные для повторения не приложены.
Если слова незнакомы — 5 терминов
- разреженное вниманиеспособ сначала быстро отбирать релевантные блоки текста и считать полное внимание только по ним
- KV-кэшвнутренняя память модели о предыдущем тексте, которая занимает место и влияет на скорость
- MoEархитектура, где для каждого токена работают только несколько выбранных экспертов, а не вся сеть
- speculative decodingметод ускорения, когда черновая модель предлагает токены, а основная проверяет и принимает их
- бюджет рассужденийограничение на количество токенов, которые модель тратит на обдумывание
Компоненты
2 шт.Формат: разбор кейса · для продвинутых · уверенность разметки 0.8 · источник