Спикулятивное декодирование: когда оно ускоряет vLLM
Что в ролике
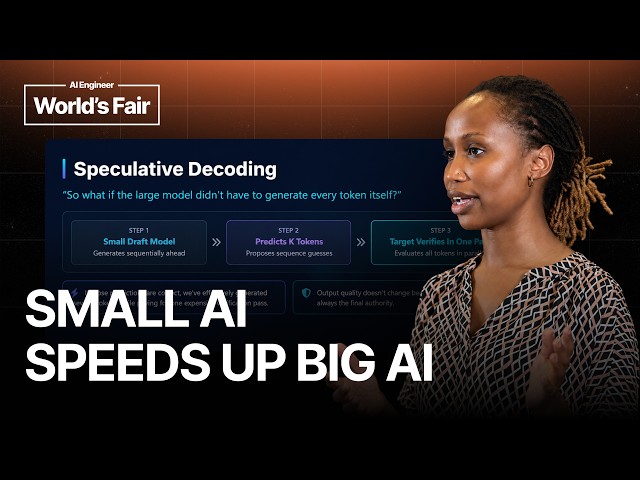
Если вы запускаете большую LLM в vLLM, то токены генерируются по одному, и это упирается в задержку. Спикулятивное декодирование добавляет вторую, маленькую модель-черновик, которая предлагает по 3–5 токенов за цикл, а основная модель проверяет их одним проходом, принимая или отбрасывая. Для такой схемы нужна свободная VRAM: в демо на одном Blackwell GPU основная модель занимает 16 ГБ весов, черновик — 2,5 ГБ, и остаётся место под KV-кэш обоих. Автор показывает два кейса: на структурированной выдаче спекуляция даёт ускорение в 1,6 раза и высокий acceptance rate, а на креативной задаче с высокой температурой acceptance rate низкий, потому что следующие токены менее предсказуемы. Выигрыш касается только фазы генерации, а не чтения длинного промпта, поэтому RAG с большим контекстом почти не ускорится. Черновик должен быть в 10–50 раз меньше основной модели, иметь тот же токенизатор и, в идеале, быть из того же семейства. Для начала советуют vLLM и его документацию, а более продвинутые варианты — Medusa и EAGLE.
Практика
- Что получишь
- Поймёте, когда включать спекулятивное декодирование и как оценить, даст ли оно ускорение: по типу задачи, свободной VRAM, длине контекста и конкурентности.
- Первый шаг
- Проверьте, есть ли свободная VRAM на GPU, и подберите черновик той же модели в 10–50 раз меньше с тем же токенизатором.
- Цифры
- —1,6 раза — ускорение генерации на структурированной выдаче в демо на Blackwell
- —16 ГБ — вес основной модели, 2,5 ГБ — вес черновика, размещённых на одном GPU
- —3–5 токенов — столько предлагает черновик за цикл до проверки основной моделью
- —10–50 раз — во столько черновик должен быть меньше основной модели
- Честно
- Автор — сотрудник Akamai, и в конце доклада зовёт в GitHub и Discord компании, где лежат материалы для повторения. В демо были технические неполадки, серверы vLLM пришлось перезапустить, но затем оба сценария показали. Конкретные конфиги и метрики видны только на экране, вслух их не называют.
Если слова незнакомы — 7 терминов
- LLMбольшая языковая модель, которая генерирует текст
- vLLMсервер для запуска языковых моделей, который ускоряет инференс и поддерживает спекулятивное декодирование
- KV-кэшпамять модели, где она хранит обработанные предыдущие токены и их связи для генерации
- acceptance rateдоля токенов от черновика, которые основная модель приняла как правильные
- RAGподход, когда модель ищет ответ в ваших документах, а не только в своей памяти
- токенизаторчасть модели, которая разбивает текст на кусочки-токены; у моделей должен совпадать
- VRAMвидеопамять GPU, куда загружаются веса моделей и кэш
Связки из этого ролика
1 шт.- vLLM + speculative decoding
Компоненты
3 шт.Формат: разбор · для практикующих · уверенность разметки 0.8 · источник