MiMo V2.6: посттренинг за 5 дней на тысячах GPU
Что в ролике
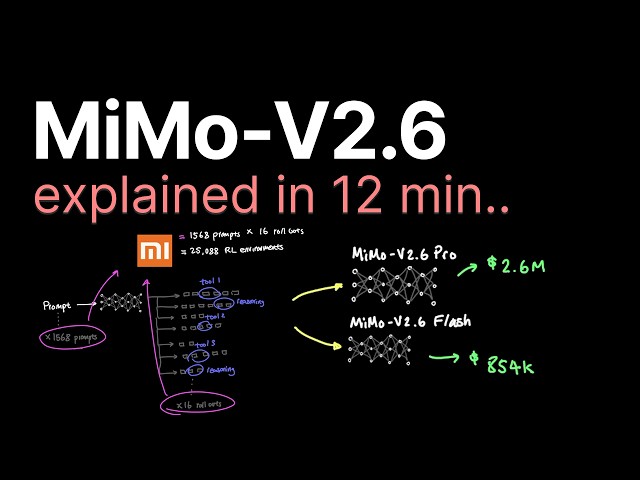
Если вы задавались вопросом, сколько стоит посттренинг большой языковой модели, Xiaomi потратила $2,6 млн на Pro и $854 тысячи на Flash, а весь процесс занял меньше 6 дней. Ключевая сложность в том, что в RL роллауты имеют разную длину и синхронизация GPU приводит к простоям, поэтому Xiaomi использует частичный роллаут, предложенный Moonshot в июне 2025 года: генерацию прерывают, сохраняют в буфер и пересчитывают KV-кэш с обновлёнными весами. Чтобы GPU не простаивали, обучение делают асинхронным, допуская временное расхождение политик (policy staleness), при этом у Flash отставание около одного шага, а у Pro почти нулевое. Для быстрого инференса модель квантуют в MXFP4, а тренировка идёт в более высокой точности, поэтому даже синхронные системы могут выдавать разные токены. Данные отбирают динамическим сэмплером, который отбрасывает группы, где все 16 попыток прошли или все провалились, оставляя смесь успешных и неудачных роллаутов. На одном шаге сэмплируют 1568 задач по 16 роллаутов, каждый в среднем генерирует 110–150 тысяч токенов, что даёт 2,8–3,8 млрд токенов за шаг, а за 30 шагов Flash потратил 81 млрд токенов, Pro — 75 млрд. Функция потерь учитывает преимущество роллаута относительно группы, отношение вероятностей новой и старой политик, адаптивный clipping и маску 0/1, а нормализация по длине не даёт длинным ответам доминировать. Для устойчивости модель обучают на 23 разных harness-окружениях, а в статье также описаны штрафы за длинные токены и неверные tool calls.
Практика
- Что получишь
- Понимание того, как устроен масштабный RL-посттренинг: частичные роллауты, асинхронность, отбор данных и функция потерь — без чтения 50-страничной статьи.
- Первый шаг
- Открыть оригинальную статью MiMo V2.6 и раздел про RL-инфраструктуру, чтобы по формулам и графикам проверить описанные механики.
- Цифры
- —$2,6 млн — стоимость посттренинга Pro-модели
- —$854 тысячи — стоимость посттренинга Flash-версии
- —30 шагов — за них Flash сгенерировал 81 млрд токенов, Pro — 75 млрд
- —25 000+ RL-сред — одновременно запущено при 1568 задачах и 16 попытках на каждую
- Честно
- Автор не продвигает платные продукты и не даёт партнёрских ссылок. Все данные взяты из открытой статьи Xiaomi; для полного понимания формул и графиков нужно открыть саму статью или поставить видео на паузу, потому что в речи они объясняются упрощённо.
Если слова незнакомы — 8 терминов
- посттренингдообучение уже обученной модели, например с помощью reinforcement learning
- роллаутодна попытка модели сгенерировать ответ от начала до конца
- KV-кэшсохранённые промежуточные вычисления модели, чтобы продолжать генерацию без повторного расчёта
- policy stalenessотставание версии модели, которая генерирует ответы, от версии, которая обучается
- квантованиеснижение точности чисел в модели для ускорения работы
- преимуществонасколько результат одной попытки лучше среднего по группе таких же попыток
- clippingограничение значения сверху и снизу, чтобы обучение было стабильнее
- harnessсреда или набор инструментов, через которые модель взаимодействует с внешним миром во время обучения
Связки из этого ролика
1 шт.- SGLang + Megatron-LM
Компоненты
4 шт.Формат: разбор · для продвинутых · уверенность разметки 0.88 · источник