Снижаем счёт за токены: измерение, модели, GPU, процессы
Что в ролике
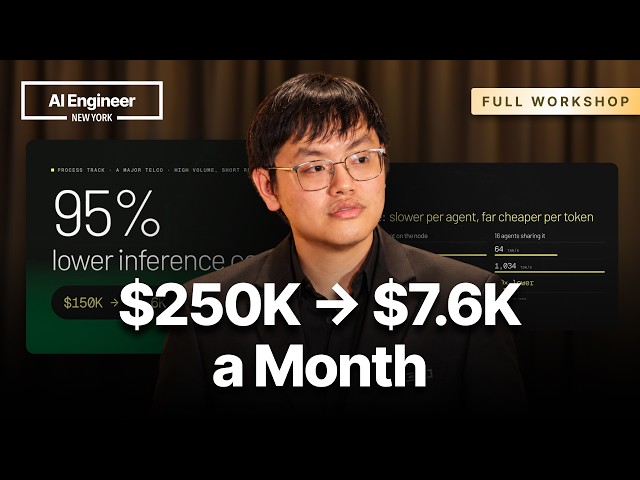
Если счёт за токены в компании растёт быстрее результатов, воркшоп Юджина Чеа из Featherless AI помогает разобрать, где именно утекают деньги: он продаёт инференс и разбирает экономику на реальных кейсах. Первый шаг — измерить траты: у половины зала нет даже общего счёта, а у 30–40% клиентов все ходят через один общий API-ключ, поэтому спикер советует делить ключи по отделам и задачам. Нагрузки он делит на агентные (длинный контекст, много повторов, только 1% выходных токенов) и процессные (короткие задачи в огромном объёме, например 10 млн сообщений в минуту у телекома). Для экономии он предлагает right-sizing: вместо одной дорогой модели использовать связку «умный планирует, дешёвый делает», а дешёвую модель делать быстрее, иначе команда не переключится. Пример: команда из пяти разработчиков тратила 150 тысяч долларов в месяц и 116 миллиардов токенов на Opus 4.8, а после перехода на ноду Gemini 5.3 расходы упали ниже 10 тысяч долларов без потери качества. В процессных задачах помогают классификаторы вроде JAF: они в 10 раз дешевле и быстрее, но не умеют вести диалог, зато закрывают значительную часть трафика. Дальше — закупка GPU: важно не гнаться за скоростью, а нагружать параллельно; одна нода при 16 параллельных запросах даёт половину скорости на запрос, но в 10 раз больше суммарного вывода и на 9–10 раз ниже стоимость. Последний шаг — проверка процессов: если агенты генерируют горы кода или слайдов без проверки, узким местом становится человек, а «слоп-гранаты» съедают пользу, поэтому нужно измерять исходы, а не использование.
Практика
- Что получишь
- План из четырёх шагов: наладить учёт токенов по отделам, подобрать более дешёвые модели под задачи, закупить выделенные мощности и убрать узкие места в процессах, а не просто резать бюджет.
- Первый шаг
- Завести отдельные API-ключи на каждый отдел и основную задачу, чтобы увидеть, кто сколько тратит токенов.
- Цифры
- —2 триллиона токенов в день — объём крупнейшего клиента Featherless AI на 512 GPU AMD MI215
- —0,03 доллара за миллион токенов — цена инференса для того клиента, в разы ниже публичных облаков
- —116 миллиардов токенов в месяц — тратила команда из пяти разработчиков до оптимизации
- —10 раз — во столько падает стоимость при 16 параллельных запросах вместо одиночных на одной ноде
- Честно
- Спикер продаёт услуги инференса Featherless AI и в конце предлагает обратиться к его команде, а также раздаёт QR-код на open-source инструмент учёта токенов. Сам воркшоп ориентирован на организации с тратами выше $10 тысяч в месяц — если вы меньше, оптимизация токенов даст меньше, чем поиск сильных кейсов. Некоторые примеры (конкретные клиенты, стоимость) даны без полных данных, а советы по подбору моделей — общие правила, которые быстро устаревают.
Если слова незнакомы — 5 терминов
- инференсвыполнение запросов к обученной модели, то есть использование AI в продакшене
- API-ключуникальный код, который определяет, кто именно посылает запросы к модели и сколько тратит
- агентпрограмма, которая сама выполняет последовательность действий, например пишет код или обрабатывает документы
- классификатормодель, которая только принимает решение по входным данным (спам/не спам, риск/не риск) без генерации текста
- нодаотдельный сервер с GPU, на котором работает модель
Связки из этого ролика
4 шт.- Planner-implementation split
- Shadow traffic
- Dedicated instances + public cloud burst
- CICD pipelines
Компоненты
15 шт.Формат: разбор · для практикующих · уверенность разметки 0.8 · источник