Когда локальный ИИ не стоит тысяч: честный разбор железа
Что в ролике
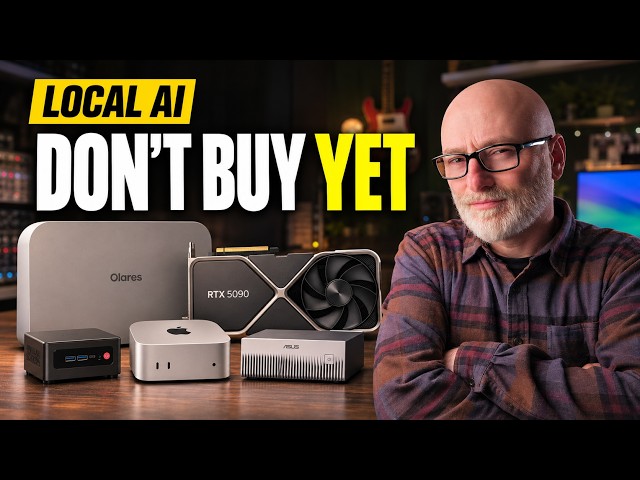
Тратить тысячи на локальный ИИ стоит только после того, как вы честно определите задачу, потому что локально запускаются и модель-движок, и программная обвязка, управляющая памятью, циклами и контекстным окном. Автор перепробовал несколько конфигураций и главными критериями называет объём памяти и её пропускную способность: первая определяет размер модели, вторая — скорость генерации токенов. ASUS GX10 с 128 ГБ унифицированной памяти выдаёт 273 ГБ/с и тянет квантованную модель Qwen Flash Next примерно на 35 токенов в секунду, но сейчас стоит около 6000 долларов. Настольная RTX 5090 с пропускной способностью 1792 ГБ/с и 32 ГБ VRAM на рынке стоит около 8000 долларов, а автору повезло купить её меньше чем за 3000. Технология Strata позволяет разбивать модель между VRAM, системной памятью и SSD, поэтому в ноутбуке Ollaris One с мобильной 5090 на 24 ГБ и 96 ГБ ОЗУ та же модель работает уже на 54 токенах в секунду при энергопотреблении всей системы 175 Вт. Отдельно он советует выбирать 24 ГБ VRAM как текущую золотую середину, для чисто ИИ-машины брать Linux, а для кочевой жизни — MacBook Pro, и напоминает, что локальные модели требуют больше ручной работы, чем Opus или Fable. Если денег на железо нет, он предлагает запустить на слабом ПК только обвязку и подключить бесплатные облачные модели через Open Code или платный DeepSeek Flash, а в конце зовёт в свой Discord почти на 4000 человек.
Практика
- Что получишь
- Понятную схему выбора: по объёму памяти и её скорости определять модель и железо, плюс понимание, когда хватит слабой машины с облачной моделью.
- Первый шаг
- Сформулировать, какую задачу должен решать локальный ИИ, и проверить по объёму VRAM и пропускной способности, какая модель вам нужна.
- Цифры
- —273 ГБ/с — пропускная способность памяти ASUS GX10, на которой модель Qwen Flash Next выдаёт около 35 токенов в секунду
- —1792 ГБ/с — пропускная способность настольной RTX 5090, которая сейчас стоит около 8000 долларов, а автору досталась меньше чем за 3000
- —54 токена в секунду — скорость той же модели на Ollaris One с мобильной 5090 при энергопотреблении всей системы 175 Вт
- —24 ГБ VRAM — объём, который автор называет текущей золотой серединой для локальных моделей
- Честно
- Видео содержит интеграцию Micro Center, а машина Ollaris One упоминается как бывший спонсор с партнёрской ссылкой. В конце автор зовёт в свой Discord-сообщество, а цены вроде 3200 евро за GX10 и меньше 3000 долларов за RTX 5090 — его личные удачные покупки, а не текущие рыночные предложения.
Если слова незнакомы — 5 терминов
- VRAMпамять на видеокарте, в которую помещается модель или её часть
- унифицированная памятьобщая память, доступная и процессору, и графике без копирования
- токены в секундускорость, с которой модель выдаёт текст: пара токенов примерно равна слову
- квантованная модельсжатая версия модели с пониженной точностью весов, чтобы влезала в меньший объём памяти
- Strataтехнология распределения модели между VRAM, оперативной памятью и SSD
Связки из этого ролика
8 шт.- NVIDIA RTX 5090
- Asus GX10 / DGX Spark
- Ollaris One
- Mac mini
- Mac Studio
- RTX 5060 Ti
- RTX 5080 Super
- RTX 3090
Компоненты
4 шт.Формат: обзор · для практикующих · уверенность разметки 0.9 · источник