NCM: быстрее писать, но память NVIDIA не исчезнет
Что в ролике
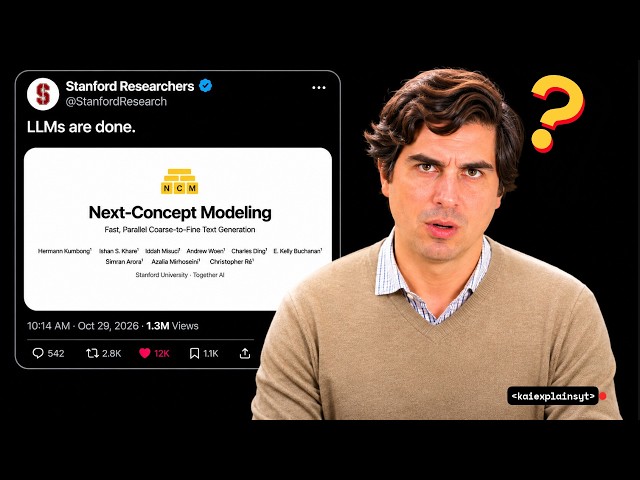
Вы видели заголовки о том, что новая модель NCM из Stanford и Together AI сделает чипы памяти ненужными, но сам ролик объясняет, почему это не так. NCM пишет текст иерархически: сначала грубый набросок кодами, затем 32 уровня детализации, и 1024 токена генерируются за 32 прохода вместо 1024, что в теории снижает нагрузку на пропускную способность памяти. Проблема в том, что память в AI-сервере выполняет две задачи: быструю подачу весов (bandwidth) и хранение контекста разговора (capacity), и NCM улучшает только первую. Реальные цифры показывают, что в сервере с GPU Rubin на 288 ГБ HBM модель Qwen 3 (27,8 млрд параметров) занимает 28 ГБ весов, а KV-кэш одного разговора на 128 тыс. токенов — 8,6 ГБ, поэтому чип вмещает около 30 таких разговоров и 260 ГБ уходит на хранение чужих бесед. Данные OpenRouter за сентябрь подтверждают: около 90% токенов, которые используют агенты, — это кэшированные промпты, свежий ввод около 9%, а вывод модели лишь около 1%, и NCM оптимизирует именно этот 1%. Сравнения скорости в статье идут только против диффузионных моделей, а не против стандартных LLM, при этом в переводе стандартная модель выигрывает 25,2 против 22,6, в генерации текста perplexity 35,5 против 83,1, и единственная убедительная победа — судоку 86,1% против 1%, где последовательная запись заведомо не подходит. Сжатие NCM теряет информацию: для обычных предложений сохраняется 99,9%, а для JSON и структурированных форматов — лишь 8%, что критично для вызовов инструментов и путей файлов. Обучение масштабных версий займёт годы: репозиторий не содержит код обучения, а самый большой протестированный вариант имеет 725 млн параметров против сотен миллиардов у ChatGPT и Claude.
Практика
- Что получишь
- Вы получите трезвую оценку NCM: где архитектура действительно ускоряет генерацию, а где упирается в неизменный KV-кэш. Сможете сами оценивать будущие статьи, задавая вопрос: ускоряет ли это запись или уменьшает объём хранения.
- Первый шаг
- Скачайте препринт NCM и открытый код и посмотрите, есть ли в нём сравнение с обычной LLM и агентными сценариями.
- Цифры
- —32 прохода вместо 1024 — так NCM генерирует 1024 токена, в 32 раза меньше обращений к весам модели
- —260 ГБ из 288 ГБ HBM на GPU Rubin уходят на хранение 30 разговоров по 128 тыс. токенов, а не на веса модели
- —90% токенов у агентов через OpenRouter — это кэшированные промпты, выход модели лишь около 1%
- —8% — столько структурированных данных (JSON и подобное) сохраняется после сжатия NCM, против 99,9% для обычного текста
- Честно
- В ролике нет рекламы или продажи курса. Основные цифры по памяти и KV-кэшу автор посчитал сам из спецификаций, их нет в статье; скорость NCM в статье достигается с включённым KV-кэшем, а код обучения на момент записи не опубликован.
Если слова незнакомы — 6 терминов
- NCMархитектура генерации текста уровнями кодов вместо последовательной записи
- HBMвысокопропускная память, уложенная рядом с GPU, чтобы быстро подавать данные
- KV-кэшпамять, где модель хранит обработанный контекст разговора, чтобы не перечитывать его заново
- bandwidthпропускная способность памяти, скорость передачи байтов
- perplexityмера неопределённости модели: чем ниже, тем лучше она предсказывает следующий токен
- диффузионная модельмодель, которая генерирует результат постепенно, уточняя его
Связки из этого ролика
5 шт.- HBM
- KV cache
- CUDA graphs
- GDDR7
- Nvidia Rubin CPX + GDDR7
Компоненты
11 шт.Формат: разбор · для практикующих · уверенность разметки 0.9 · источник