Как устроены интерактивные AI-аватары на сайтах
Что в ролике
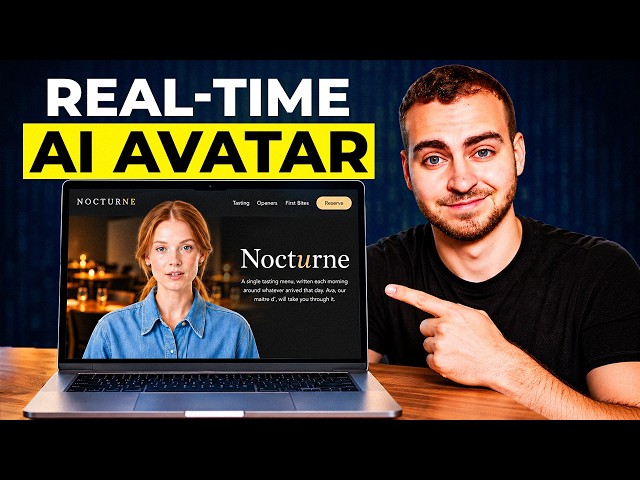
Чтобы говорящий аватар не выглядел сломанным, весь конвейер от речи до ответа строится вокруг задержки: в обычном разговоре пауза между репликами около 200 миллисекунд. Автор показывает ресторанный сайт Nocturne, где аватар Ava принимает заказ и подсвечивает блюда на странице. Соединение идёт через WebRTC и LiveKit: в одной комнате находятся браузер, Python-агент и сама аватара. Агент последовательно запускает VAD, распознавание речи, определение конца реплики, LLM, инструменты и text-to-speech, причём токены озвучиваются по мере генерации. Лицо рендерит Synthesia через API-плагин для LiveKit, а клиентская часть занимает около 30 строк. Для сборки нужны три файла: token-сервер, агент и веб-страница, плюс ключи LiveKit и Synthesia. Автор подчёркивает, что не писал код руками, а добавил Synthesia skill в Claude Code или Cursor.
Практика
- Что получишь
- Понимание полной архитектуры интерактивного аватара и готовый путь к запуску бесплатного прототипа с голосовым управлением страницей.
- Первый шаг
- Создать бесплатный проект на cloud.livekit.io и аккаунт Synthesia, затем скачать код из описания и запустить server.py вместе с agent.py.
- Цифры
- —200 миллисекунд — обычная пауза между репликами в разговоре, на которую равняются системы
- —12 центов — стоимость минуты интерактивного аватара Synthesia после исчерпания бесплатных кредитов
- —30 строк — объём клиентского кода в браузере для подключения к LiveKit-комнате
- —90% компаний из Fortune 100 используют Synthesia по данным автора
- Честно
- Видео спонсировано Synthesia, и весь пример строится на её платном API — бесплатных кредитов хватает на тест, но в проде минута стоит 12 центов. Код и ссылки лежат в описании, а готовые роль-плей сессии и часть настроек находятся внутри Synthesia. В пересказе нет полных листингов, поэтому часть кода и точные значения ключей придётся смотреть на экране или в репозитории.
Если слова незнакомы — 4 терминов
- WebRTCтехнология потоковой передачи аудио и видео в браузере, как в видеозвонках
- LiveKitсервис для создания комнат видеозвонков, который маршрутизирует участников и потоки
- VADдетектор голосовой активности, отличающий речь от фонового шума
- LLMбольшая языковая модель, которая генерирует ответы агента
Связки из этого ролика
2 шт.- LiveKit + Synthesia
- Claude Code + Cursor + Synthesia skill
Компоненты
7 шт.Формат: пошаговый урок · для практикующих · уверенность разметки 0.85 · источник