Revolut: self-hosted GLM вместо API — расходы в 10 раз ниже
Что в ролике
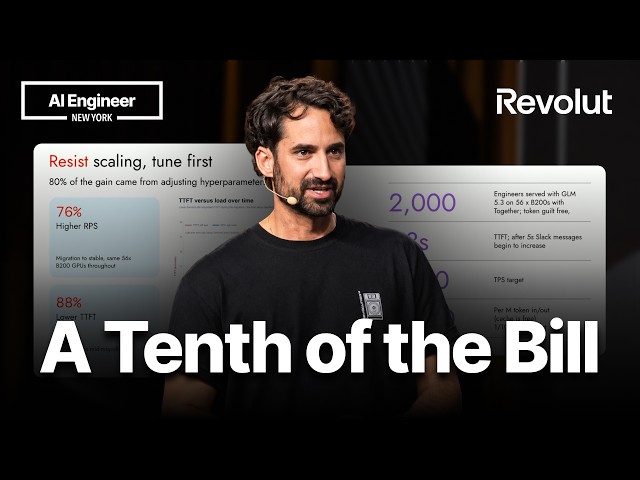
Revolut обслуживает 80 миллионов клиентов в 45 странах и с февраля 2025 тестирует AI-помощников в разработке: сначала Gemini сократил lead time на 10% и время кодинга на 20%, а Claude Code почти не повлиял, и расходы на AI доходили до 1 000–10 000 долларов на инженера в месяц без явного ROI. Поэтому в апреле компания начала self-hosted инференс открытой модели GLM на 56 GPU B200 и увидела 60% улучшение времени кодинга и 70% сокращение lead time. Главный экономический результат — blended-стоимость токена 30 центов за миллион, что делает инвойс в 10 раз меньше, чем при работе с Anthropic и OpenAI, и убирает шок от счетов в конце месяца. На тех же 56 GPU за счёт тюнинга параметров время первого токена удалось снизить с более чем 10 секунд до 1,6 секунды при росте запросов на 76% — это 88% прирост производительности. Среди настроек спикер советует не увлекаться длинным контекстом (достаточно 256 тысяч токенов), использовать квантование не выше FP4 на Blackwell, подбирать tensor parallelism по KV-кэшу и держать cache hit выше 90%. Для продакшена text-only GLM дополняют локальным роутером: запросы с картинками уходят в Gemini или Llama, а основной код остаётся на GLM, эндпоинты совместимы с OpenAI API и работают в OpenCode. Отдельный блок для безопасников: веса китайской модели размещают на инфраструктуре в США или Европе, все задачи идут с человеком в цикле, а песочница с правилами approve/deny и открытая телеметрия дают аргументы для регулятора.
Практика
- Что получишь
- Поймёте, какие метрики и настройки важны при self-hosted инференсе открытых моделей для разработки, и как объяснить безопасность такого решения регулятору.
- Первый шаг
- Начните с аудита текущих AI-расходов на разработку и ограничьте API-доступы, чтобы потом сравнить их с self-hosted вариантом на GLM.
- Цифры
- —30 центов за миллион токенов — blended-цена self-hosted GLM, в 10 раз ниже прежних расходов
- —56 GPU B200 — столько нужно, чтобы обслуживать 2 000 инженеров моделью GLM
- —1,6 секунды — время первого токена после тюнинга, стартовое было более 10 секунд
- —88% — прирост производительности при 76% росте нагрузки на тех же GPU
- Честно
- Это запись доклада, а не пошаговое руководство: команд и конфигов на экране нет, только графики и тезисы. Спикер прямо рекомендует self-hosted GLM и приводит цифры Revolut, но не продаёт курс или партнёрскую ссылку. Часть названий в расшифровке могла исказиться (например, Cloud Code вместо Claude Code или Luna вместо Llama), поэтому точные версии моделей стоит сверить с оригиналом.
Если слова незнакомы — 6 терминов
- self-hostedзапуск модели на своих или арендованных GPU, а не через внешний API
- инференсвыполнение моделью запросов
- lead timeвремя от взятия задачи до готовности к деплою
- квантованиесжатие весов модели для экономии памяти и ускорения
- KV-кэшвнутренний кэш модели, влияющий на возможность параллельной обработки запросов
- cache hitдоля запросов, обработанных без повторного вычисления
Компоненты
5 шт.Формат: разбор кейса · для продвинутых · уверенность разметки 0.9 · источник