GEPA: рефлексивная оптимизация промптов вместо RL
Что в ролике
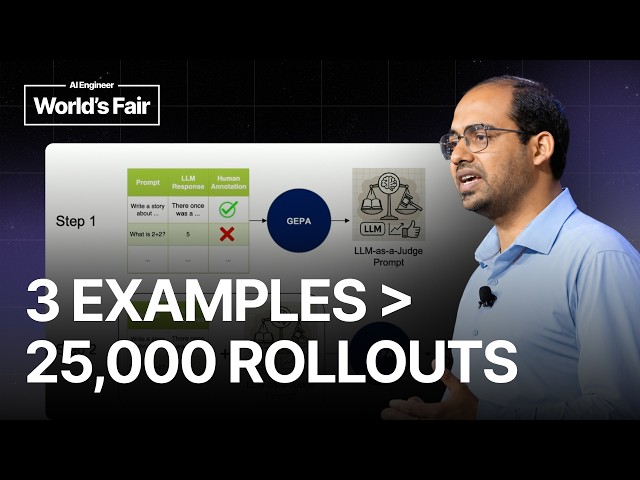
Обучение моделей через градиентный спуск обычно требует триллионы токенов на предобучении, десятки тысяч размеченных примеров на SFT и сотни тысяч прогонов на RL, тогда как у большинства команд таких данных и вычислений нет. GEPA (в речи звучит как «Джепа») вместо весов обновляет промпт: агент смотрит на полный трейс прогона, рефлексирует над ошибками и формулирует новое текстовое поведение, а одна замена слова в промпте может дать скачок поведения без тысяч градиентных шагов. Автор показывает, что GEPA за один раунд рефлексии на трёх примерах даёт вдвое больший прирост, чем GRPO после 25 000 прогонов, при этом модель Qwen 3 8B оптимизирует сама себя без внешнего учителя. Алгоритм работает просто: запускает пайплайн на нескольких примерах, собирает доменную обратную связь, LLM предлагает улучшенный промпт, а пул по Парето сохраняет всех кандидатов, которые выиграли хотя бы на одном примере, не застревая в локальных оптимумах. На практике GEPA поднял агента с точностью 4,25% до 30,52% на новой задаче программирования NPU AMD XDNA2, где информации в интернете почти не было, и за один шаг нашёл, что поставляемая библиотека ADF не работает с новым железом. Расширение Optimize Anything позволяет оптимизировать любой текстовый параметр: CUDA-ядро, всю агентскую обвязку, навыки, политику облачного планирования; например, из простого четырёхстрочного Python-агента за 16 раундов рефлексии появился шестишаговый агент, поднявший точность Gemini Flash на RKGI с 32,5% до 89,5%. Отдельный режим GSkill учит навыки для репозиториев: оптимизировав дешёво на GPT-5 mini, удалось поднять решение issue с 24% до 93%, а перенеся навыки на Claude Sonnet — довести до 100% и почти вдвое сократить время. По заверению автора, Optimize Anything уже используют Snorkel, Databricks и другие, а Databricks получил 90-кратное снижение стоимости, настроив GPT-OSS 120B на уровень выше Claude Opus.
Практика
- Что получишь
- Открытый репозиторий с GEPA и Optimize Anything, который можно подключить к своему агенту или пайплайну и автоматически находить улучшенные промпты, агентные архитектуры и навыки по небольшому числу примеров.
- Первый шаг
- Скачать репозиторий GEPA и запустить оптимизацию на нескольких своих примерах, передав задачу с функцией-оценщиком, как показано в документации.
- Цифры
- —25 000 — столько прогонов GRPO потребовалось для результата, который GEPA дал за один раунд на трёх примерах (прирост вдвое больше)
- —4,25% → 30,52% — рост точности агента на задаче программирования NPU AMD XDNA2 после применения GEPA
- —32,5% → 89,5% — точность Gemini Flash на задаче RKGI после того, как Optimize Anything за 16 раундов нашёл шестишагового агента
- —24% → 93% — точность решения issue в go-репозитории у GPT-5 mini после оптимизации навыков, а после переноса на Claude Sonnet она достигла 100% и время сократилось вдвое
- Честно
- Автор продвигает собственный открытый проект GEPA/Optimize Anything, и большинство цифр — из его собственных экспериментов, без воспроизводимых на экране деталей для всех случаев. Для повторения понадобится смотреть код на экране и репозиторий, а часть результатов (Snorkel, Databricks) дана со слов автора.
Если слова незнакомы — 7 терминов
- RLобучение с подкреплением, где модель учится по наградам
- SFTsupervised fine-tuning, дообучение на размеченных примерах
- GRPOалгоритм RL, преобразующий награды прогонов в обновления весов
- прогонодин полный запуск модели или агента от входа до награды
- промпттекст задания, управляющий поведением модели
- LLMбольшая языковая модель
- пул по Паретонабор кандидатов, где каждый силён хотя бы на одном примере, чтобы не потерять полезные варианты
Связки из этого ролика
3 шт.- Python
- CUDA
- JavaScript
Компоненты
15 шт.Формат: разбор · для продвинутых · уверенность разметки 0.82 · источник