Что может ZGX Fury: локальные модели, агенты и RAG
Что в ролике
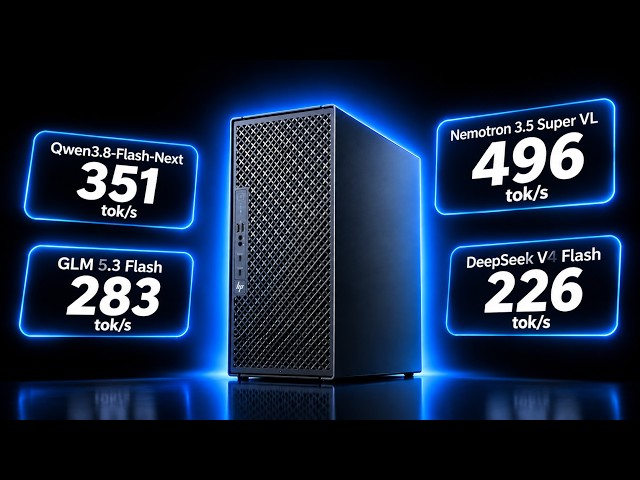
Для команд, которым нужен полностью локальный ИИ, ZGX Fury показывает, какие модели влезают и с какой скоростью работают. Автор загружает одновременно GLM 5.3 Flash (320 млрд параметров, около 180 ГБ), несколько мелких моделей и эмбеддинг Gemma 2, оставляя место под KV-кэш. Он объясняет, что скорость декодирования упирается в пропускную способность памяти: у HBM это 7,1 ТБ/с, у памяти CPU — 396 ГБ/с, поэтому большие модели имеет смысл держать в HBM. GLM 5.3 Flash выдаёт около 283 токенов/с для одного пользователя со спекулятивным декодированием и около 80 токенов/с на пользователя при 16 одновременных сеансах, а DeepSeek 4 Flash обслуживает 54 пользователей с минимум 40 токенов/с. Для агентов автор считает порог в 80 токенов/с на пользователя, потому что цепочки рассуждений быстро умножают задержку. В офлайн-демо он отключает сеть и запускает команду кодинг-агентов через DeepSync, а для приватного RAG использует связку эмбеддингов Gemma 2, ре-ранкера Qwen и LLM уровня Qwen 3.8 Flash или GLM 5.3 Flash. Транскрибация аудио на этой машине идёт со скоростью 410x реального времени, а генерация 720p-видео через LTX 2.5 или Miniax H3 занимает десятки секунд; следующее видео будет про обучение и файнтюн.
Практика
- Что получишь
- Понимание, какие локальные модели реально помещаются на одной машине и какую скорость и число одновременных пользователей от них ждать. Также видно, какие сценарии — агенты, RAG, аудио, видео — можно закрыть без интернета.
- Первый шаг
- Посчитать по формуле из видео, сколько памяти займёт ваша целевая модель: параметры × битность / 8, и сравнить с 252 ГБ HBM у ZGX Fury.
- Цифры
- —252 ГБ — объём HBM-памяти на GPU, куда помещаются самые быстрые модели; ещё 496 ГБ медленной памяти у CPU
- —7,1 ТБ/с — пропускная способность HBM против 396 ГБ/с у памяти CPU
- —283 токена/с — скорость GLM 5.3 Flash для одного пользователя со спекулятивным декодированием
- —54 пользователя — столько одновременных сеансов тянет DeepSeek 4 Flash с минимум 40 токенами/с на каждого
- Честно
- Видео спонсировано HP и Nvidia, поэтому цифры поданы позитивно и получены самим автором на его машине, а не независимым тестом. Конкретные команды, конфиги и часть названий моделей видны только на экране. Для повторения нужен сам ZGX Fury или аналогичное железо с 252 ГБ HBM и поддержкой NVFP4, а инструкции по настройке DeepSync даны в других роликах.
Если слова незнакомы — 5 терминов
- KV-кэшпамять, в которой модель хранит историю разговора для каждого пользователя
- спекулятивное декодированиеприём, когда черновая модель угадывает следующие токены, а основная проверяет их разом
- RAGпоиск по вашим документам и добавление найденных кусков в запрос к модели
- эмбеддингичисловые векторы, в которые превращают текст или картинки для поиска и сравнения
- ре-ранкермодель, которая пересортировывает найденные документы по релевантности
Связки из этого ролика
3 шт.- Local RAG: Embedding Gemma 2 + Qwen re-ranker + LLM
- Offline coding agents: multiple models via DeepSeek harness
- Video generation: Qwen Image Edit / MOSS Image + LTX 2.5 / MiniMax H3 + prompt rewriter LLM
Компоненты
13 шт.Формат: обзор · для практикующих · уверенность разметки 0.8 · источник