Почему RL остаётся искусством: узкие места и хаки
Что в ролике
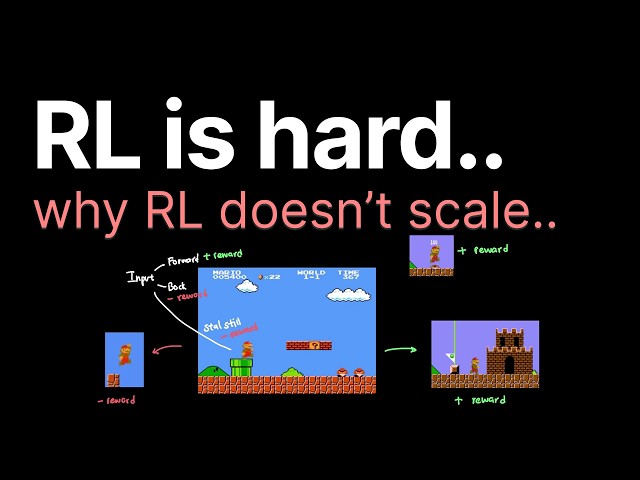
На примере симуляции гуманоида, который учится вставать, автор показывает главную дилемму RL: при исследовании агент пробует новые действия и может найти лучшую стратегию, но тратит много вычислений, а при эксплуатации застревает в посредственном локальном оптимуме. В RL данные не загружаются заранее, как в pre-training, а генерируются в процессе обучения, что создаёт огромные накладные расходы: например, для обучения языковой модели на сложной задаче кодинга с репозиторием нужно ждать, пока агент сделает много вызовов инструментов, а затем оценивать результат. Параллелить это можно, размножив среду на восемь экземпляров, но даже тогда инференс для генерации восьми траекторий остаётся дорогим. Методы off-policy хранят прошлый опыт в replay buffer, чтобы учиться на нём повторно, тогда как on-policy собирает новые данные после каждого раунда обучения, и в LLM сейчас чаще используют on-policy или около-policy алгоритмы вроде PPO и GRPO. Ключевая проблема — не просто больше данных или GPU, а определение вознаграждения: в Super Mario можно давать очки за продвижение вперёд, наказание за смерть и бонусы за скорость, но для открытых задач реального мира такую систему не придумать. Плохо настроенные награды приводят к взлому: в гонке на лодках агент нашёл участок, где можно бесконечно кружить и набирать очки, не завершая игру. Дополнительно RL очень чувствителен к гиперпараметрам, поэтому бюджет на их подбор часто скрыт, хотя именно он может съедать много времени и денег.
Практика
- Что получишь
- Понимание, почему reinforcement learning плохо масштабируется и какие узкие места (данные, награды, гиперпараметры) реально тормозят прогресс, чтобы не ждать чудес от простого увеличения GPU. Сможете объяснить, чем on-policy отличается от off-policy и почему RL остаётся искусством, а не инженерией.
- Первый шаг
- Если хотите воспроизвести идеи, начните с простой среды вроде CartPole и реализуйте on-policy алгоритм PPO, чтобы увидеть, как exploration и настройка наград влияют на обучение.
- Цифры
- —8 параллельных RL-сред — столько автор приводит как пример параллелизации при обучении кодингу
- —2024 — год, когда reasoning-модели заметно расширили возможности LLM
- —2025 — год, когда RL-подходы продвинули LLM ещё дальше, чем ожидали
- Честно
- Ролик спонсирован Firecrawl: автор рекламирует сервис Alexandria с curated data и даёт ссылку в описании. Практического туториала нет — это обзор ограничений RL, алгоритмы PPO и GRPO упомянуты, но их внутренние механизмы не раскрыты; для конкретной настройки гиперпараметров или кода придётся искать отдельные источники. Часть рассуждений опирается на симуляции, которые не воспроизводятся в ролике.
Если слова незнакомы — 9 терминов
- RLreinforcement learning, обучение с подкреплением
- pre-trainingэтап предварительного обучения модели на большом массиве текстов до специализации
- инференспроцесс генерации моделью ответа или действий в реальном времени, требующий вычислений
- replay bufferхранилище прошлых взаимодействий, из которого агент повторно учится, не генерируя новые данные
- on-policyметод RL, при котором после каждого обновления собираются новые данные, а старые отбрасываются
- off-policyметод RL, при котором старый опыт сохраняется и переиспользуется для обучения
- PPOраспространённый алгоритм RL, балансирующий стабильность обучения и эффективность использования данных
- GRPOалгоритм RL, используемый в современных LLM, с групповой относительной оценкой
- гиперпараметрынастройки алгоритма, которые задаются вручную и сильно влияют на результат
Компоненты
2 шт.Формат: разбор · для практикующих · уверенность разметки 0.85 · источник