Как банк допускает AI-приложения, а не модели
Что в ролике
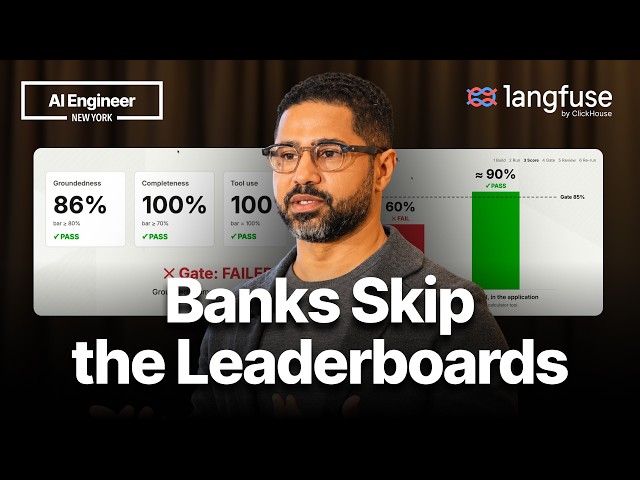
Если вы работаете в банке или другой регулируемой отрасли, вам важны не публичные бенчмарки, а доказательство, что конкретное приложение готово к production. Инженер Langfuse (входит в ClickHouse) разбирает опыт с банком из топ-5, где для инвестиционных аналитиков строили 10K-аналитика: после звонка о доходах он должен быстро выдавать анализ стенограмм с учётом внутренних знаний банка. Банк требовал держать всё на своих мощностях, с контролем и без доступа наружу, поэтому оценка строилась вокруг «золотого набора» вопросов и следов прогонов как доказательства. На старте одна модель набрала 97 процентов по опоре на внутренние данные, но только 60 процентов по точности расчётов, потому что LLM плохо считают. Модели добавили инструмент-калькулятор на Python, после чего точность расчётов выросла до 95 процентов, и приложение прошло порог банка в 85 процентов. Оценка велась по нескольким измерениям: опора, полнота, удобство и регуляторное соответствие, причём регуляторный провал бинарно ставил ноль и блокировал выпуск, даже если среднее по остальным метрикам высокое. Доменные эксперты задают пороги и вручную разбирают сбои через очередь аннотаций, а их правки возвращаются в «золотой набор». В результате оценка приложений сократилась с недель и месяцев до минут, а код и блог выложены в открытый доступ.
Практика
- Что получишь
- Понимание, как построить собственную систему допуска AI-приложений с порогами по измерениям и инструментами для LLM там, где модели слабы.
- Первый шаг
- Собрать «золотой набор» из вопросов, ожидаемых ответов и метаданных, на котором будете прогонять каждое изменение приложения.
- Цифры
- —97 процентов — опора на внутренние данные у одной модели на старте
- —60 процентов — точность числовых расчётов до добавления инструмента
- —95 процентов — точность расчётов после добавления Python-калькулятора
- —85 процентов — порог банка для допуска этого приложения
- Честно
- Автор — инженер Langfuse, поэтому доклад продвигает их платформу как основной инструмент оценки, но общий процесс применим и без неё. Код и подробный разбор обещаны в блоге и репозитории; в видео показаны только фрагменты, а интерфейс и значения порогов видны лишь на слайдах.
Если слова незнакомы — 3 терминов
- LLMбольшая языковая модель, которая предсказывает следующий токен
- productionбоевая среда, где приложением пользуются реальные пользователи
- золотой наборэталонный набор вопросов с ожидаемыми ответами для проверки приложения
Компоненты
2 шт.Формат: разбор кейса · для практикующих · уверенность разметки 0.88 · источник